

Довга дуга інтелекту: як 80 років інженерії створили сучасні LLMs
Сторічна історія великих мовних моделей — від ранньої теорії ймовірностей і обчислень часів Холодної війни до нейронних мереж, трансформерів, законів масштабування та виникнення сучасного ШІ. Глибоке…
In this article 30 sections
Introduction: The Machines That Predict Us
Більшість людей вперше зіткнулися з великими мовними моделями за останні кілька років — зазвичай у формі вікна чату, яке, здавалося, прокинулося одного дня і почало говорити. Майже за ніч програмне забезпечення, яке ледве могло виправити вашу орфографію, раптом почало писати код, підсумовувати судові справи, складати іспити на ліцензію та вести розмови, які здавалося, були надто людськими. Це виглядало як наукова фантастика, що вибухнула в повсякденному житті.
Але правда набагато дивніша. Ці системи не з'явилися нізвідки. Вони є сучасним вираженням ідеї, яка старша за самі цифрові комп'ютери — ідеї, що виникла з ранньої теорії ймовірностей, військової сигналізації та перших спроб формалізувати, як інформація протікає. В деяких відношеннях інтелектуальним предком ChatGPT є не інше програмне забезпечення, а радарна консоль під час Холодної війни.
Основний трюк, що стоїть за сучасним ШІ, надзвичайно простий: Прогнозування. Виходячи з того, що було раніше, що, ймовірно, буде далі? Закінчіть речення. Продовжте шаблон. Розширте сигнал. Це суть. Все інше — це масштаб, інженерія та упаковка.
Проте, незважаючи на те, що ми точно знаємо, як ці системи побудовані — кожен рядок коду, кожна математична операція, кожен алгоритм навчання — ми все ще не можемо повністю пояснити чому вони працюють так добре. Ми розуміємо механізми, але не повністю розуміємо внутрішні представлення, які еволюціонують всередині. Вони є штучними організмами ймовірності, сформованими під впливом трильйонів слів, що пульсують з шаблонами, які ми можемо виміряти, але не можемо повністю перекласти.
Ця стаття є спробою розкрити цю технологію, розповідаючи довгу, безперервну історію: від ранніх ймовірнісних головоломок у 1900-х роках до комп'ютерів повітряної оборони Холодної війни, які фактично виконували примітивне моделювання послідовностей, до переходу від правил на основі ШІ в 1960-х роках, до статистичної революції 1990-х років, до нейронних мереж 2000-х років і, нарешті, до архітектури трансформерів, яка зробила можливими сучасні LLM.
Ця історія не є історією раптового генія. Це історія масштабування, повторного відкриття, забутих ідей і несподіваних наслідків збільшення моделей і надання їм більше даних. Найголовніше, це історія інструмента, дизайнери якого можуть відкрити капот і описати кожен компонент, але все ще борються з поясненням виникаючого інтелекту, що гудить всередині.
До кінця цієї статті середній читач повинен не лише зрозуміти, що таке велика мовна модель, але й чому самі експерти іноді чесно кажуть, що ми не повністю знаємо, що відбувається всередині.
What a Language Model Actually Is
Перш ніж зануритися в історію, давайте розвіємо міфи. Що саме таке мовна модель?
Забудьте слово "інтелект". Забудьте про роботів, свідомість або метафори наукової фантастики. В основі, мовна модель — це просто двигун ймовірності, навчений вгадувати наступний елемент послідовності.
Слова, символи, токени — це не має значення. Машина бачить часткову послідовність і присвоює ймовірності тому, що може слідувати. Потім вона вибирає одне і повторює процес знову і знову, поки ви не скажете їй зупинитися. Ось і все.
Якщо я почну речення з:
The sky turned dark as the storm…
ви, напевно, зможете його закінчити: підходив, вкотився, утворив тощо. Ваш мозок підсвідомо обчислює ймовірності на основі шаблонів з кожного опису бурі, який ви коли-небудь чули.
Мовна модель робить щось подібне, але на масштабі, до якого людський мозок не може дотягнутися. Якщо ви навчите машину на кожній книзі, що коли-небудь була оцифрована, кожній статті Вікіпедії, кожній новинній історії, кожній темі на форумі, кожному блозі, кожному рядку коду на GitHub — трильйони слів — вона почне інтерналізувати статистичну структуру того, як люди пишуть, міркують, сперечаються, пояснюють і розповідають історії. Вона не розуміє значення так, як ми, але захоплює шаблони значення, що часто достатньо, щоб виглядати розумно.
Простими словами:
LLM не думають; вони глибоко, profoundly, неймовірно прогнозують.
Але це ставить питання: якщо механізм такий простий, чому результати здаються такими складними?
Відповідь полягає в масштабі. Шаблони, які є слабкими, фрагментованими або невидимими на малих розмірах, стають багатими і узгодженими, коли модель піддається величезним даним і отримує трильйони можливостей для коригування своєї внутрішньої структури. Щось виникає — не свідомість, а компетентність. Не розуміння, а поведінка, що імітує його.
The Strange Problem of Knowing and Not Knowing
Ось парадокс, який плутає громадськість: дослідники ШІ кажуть, що розуміють як працюють LLM, але не чому вони працюють. Це може звучати як відмовка або навіть нечесність, тому важливо прояснити.
Уявіть, що хтось будує автомобільний двигун і фотографує кожен гвинт і шестерню. Вони знають схеми. Вони знають, як працює впорскування пального, як рухаються ремені ГРМ, як працюють поршні. Вони можуть відтворити всю машину з нуля.
Тепер уявіть, що вони запускають двигун — і замість того, щоб працювати як автомобіль, він починає генерувати музику. Ідеально структуровані, ніколи не чуті раніше композиції.
Інженери знають механіку того, що вони побудували. Вони не розуміють виникаючого феномену, який з'явився.
Ось що відбувається з LLM.
Ми знаємо кожну частину:
The architecture (transformers).The math (matrix multiplication, non-linear functions).The training objective (minimize next-token prediction error).The parameters (billions of learned numerical values).The hardware it runs on (GPU clusters).
Але ми ще не можемо перевести внутрішні уявлення в людські концепції. Модель організовує знання таким чином, що не відповідає чітко нашим категоріям значення. Кластер нейронів може кодувати концепцію, таку як "заперечення" або "сарказм" або "виявлення загрози", але у нас ще немає універсального словника, який пояснює, як.
LLM не є чорними ящиками, тому що ми не маємо доступу; вони є чорними ящиками, тому що їхні внутрішні абстракції є чужими для людського мислення.
Ми знаємо, що входить.
Ми знаємо, що виходить.
Ми знаємо, як працює механізм.
Те, що ми ще не можемо зробити, це інтерпретувати внутрішню мову, яку модель використовує для вирішення проблеми.
Ось чесна правда:
LLM прозорі в механізмі, але непрозорі в значенні.
Ось чому безпека ШІ та інтерпретованість є активними дослідницькими полями. Справа не в тому, що моделі приховують секрети — справа в тому, що вони організовують інформацію таким чином, як ніхто з людей ніколи не бачив раніше.
The Long Prehistory: How the 1940s Invented Modern AI
Коли люди чують "велика мовна модель", вони думають про GPU, глибоке навчання та Кремнієву долину. Але основна ідея виникла задовго до того, як все це існувало — з математиків, які намагалися зрозуміти невизначеність.
Перший іскра прийшла від Андрія Маркова на початку 1900-х років, який аналізував послідовності літер у російській поезії і виявив, що можна змоделювати ймовірність кожної літери, враховуючи попередню. Він створив "ланцюг Маркова", простий, але потужний спосіб прогнозувати послідовності.
Але справжнім батьком сучасного мовного моделювання був Клод Шеннон. У 1948 році він написав "Математичну теорію зв'язку", основоположну статтю, яка фактично винайшла теорію інформації. У ній Шеннон створив примітивні текстові генератори, використовуючи статистику англійської мови. Він взяв великі вибірки англійського письма, обчислив, як часто кожна літера (або слово) слідує за іншими, і використав ці ймовірності для генерації нового тексту.
Деякі з виходу звучать моторошно, як ранні версії машинно згенерованого нонсенсу:
“THE HEAD AND IN FRONTAL ATTACK ON AN ENGLISH WRITER THAT THE CHARACTER OF THIS POINT IS THEREFORE ANOTHER METHOD FOR THE LETTERS.”
Це нісенітниця, але це структурована нісенітниця — статистично обґрунтований шум, який імітує ритм англійської мови.
Це, по суті, була перша мовна модель.
Але стрибок від теорії до механізму стався через війну.
Під час Холодної війни Сполучені Штати побудували величезні ранні комп'ютери — Whirlwind, SAGE, AN/FSQ-7 — для виявлення бомбардувальників. Ці машини отримували шумові радіолокаційні сигнали і будували ймовірнісні моделі того, що ці сигнали означали. Повернення радіолокації не є словом, але проблема ідентична: враховуючи послідовність шумових спостережень, який найбільш ймовірний наступний стан? Куди йде ціль? Це реальність чи шум?
Ці ранні системи оборони виконували моделювання послідовностей в реальному часі за десятиліття до того, як "ШІ" існувало як галузь. Вони були прототипами LLM аналогової ери — машини, призначені для фільтрації, прогнозування та класифікації шаблонів у потоках даних.
До В'єтнамської війни системи, такі як Igloo White, використовували мережі датчиків, статистичні моделі та інституційні комп'ютери для автоматичного інтерпретування сигналів з поля бою. Це було грубо, але концептуально узгоджено з тим, що ми пізніше назвемо машинним навчанням.
LLM здаються новими, тому що вони говорять.
Їхні предки не говорили — вони слухали.
Але основна математика вже існувала.
The Rise and Fall of Symbolic AI (1960s–1980s)
Коли ми намагалися навчити машини значення вручну
На початку 1960-х років комп'ютери еволюціонували з військових калькуляторів у інструменти наукової цікавості. Холодна війна надала США та Великій Британії величезний стимул для просування обчислень, але коли безпосередній військовий тиск зменшився, дослідники звернули свою увагу на щось ще більш амбітне: навчання машин розуміти мову.
Ця епоха — часто називана символічним ШІ або старомодним ШІ (GOFAI) — була побудована на оманливо простій вірі:
If intelligence is reasoning, and reasoning is manipulating symbols, then intelligence must be programmable.
Людське мислення здавалося серією правил і визначень: якщо X, то Y, об'єкт має властивість Z, дієслово модифікує іменник і так далі. Якщо ми зможемо чітко записати ці правила, можливо, ми зможемо закодувати саме розуміння.
Це був інтелектуальний настрій, що оточував перші спроби машинної мови.
ELIZA — Перша машина, яка відповідала (1966)
У 1966 році комп'ютерний вчений MIT Джозеф Вайценбаум випустив ELIZA, програму, яка стала легендарною. ELIZA нічого не розуміла. Вона виконувала просте зіставлення шаблонів:
If the user says “I feel X,” respond with “Why do you feel X?”If the user mentions a family member, ask a question about that person.If the user complains, encourage them to elaborate.
Найвідоміший сценарій, названий DOCTOR, імітував психотерапевта Рожеріанця. Ви вводите свої занепокоєння; вона відображає їх назад з незначними перетвореннями.
Це було так просто, що ви могли надрукувати всю логіку на одній сторінці.
І все ж — люди виливали свої серця ELIZA. Вони довіряли, покладалися на неї і в деяких випадках вірили, що вона розуміє їх краще, ніж реальні люди. Вайценбаум був стурбований цим. Він створив ELIZA, щоб продемонструвати наскільки поверхневою насправді була цифрова "розмова", лише щоб виявити, що люди проєктують глибину на шаблони, які нагадують емпатію.
ELIZA стала першим уроком у шаблоні, який повторюється навіть зараз:
Люди схильні приписувати розуміння там, де його немає. Машинам не потрібні розуми — їм потрібен лише вигляд одного.
SHRDLU — Погляд на справжнє розуміння у маленькому світі (1970)
Кілька років потому дослідник Стенфорда Террі Віноград створив SHRDLU, який був набагато більш складним, ніж ELIZA. SHRDLU жив у маленькому, змодельованому "світі блоків", що складається з пірамід, кубів і коробок. Ви могли вводити команди природною мовою:
“Pick up the red pyramid.”“Put it on the green cube.”“What is the thing on top of the blue block?”
SHRDLU аналізував граматику, розв'язував посилання ("це", "той"), запам'ятовував об'єкти і міркував про світ. У своєму обмеженому середовищі він здавався майже магічним — ніби комп'ютер дійсно розумів мову.
Але світ блоків був ретельно спроектованою ілюзією. SHRDLU досяг успіху, тому що світ був маленьким, послідовним і підпорядкованим правилам. Справжня мова — з її неоднозначністю, метафорами, культурними нюансами, сарказмом і суперечностями — зруйнувала цей підхід.
Символічна ера натрапила на стіну:
Щоб зрозуміти справжню мову, вам знадобиться мільйони правил і мільярди винятків. Жодна команда дослідників ніколи не зможе їх усіх написати.
Обмеження стають очевидними
Символічний ШІ розглядав мову як головоломку граматики та логіки. Але мова не є головоломкою. Мова є статистичним артефактом людської культури — безладною, нерегулярною, історичною і повною крайніх випадків.
Запитайте символічну систему ШІ про інтерпретацію:
“Time flies like an arrow; fruit flies like a banana.”
Символічна система зламається. Статистична система помітить шаблон, оскільки вона вже бачила фрази на кшталт "фруктові мухи" раніше.
Символічний ШІ був геніальним, але крихким. Він досяг успіху лише тоді, коли світ був маленьким, контрольованим і герметичним.
Справжній світ не є жодним з цих речей.
На початку 1980-х років імпульс символічного ШІ сповільнився. Дослідники дізналися щось критичне, хоча ще не знали, чим замінити старий підхід:
Language isn’t rule-first — it’s pattern-first.To understand language, you must understand probability.
І це усвідомлення відкриє наступну еру.
The Statistical Revolution (1980s–1990s)
Коли ми нарешті прийняли, що мова в основному є математикою
Поки дослідники символічного ШІ намагалися побудувати розуміння з логіки, нова хвиля комп'ютерних лінгвістів та промислових дослідників взяла радикально інший погляд:
Stop trying to encode meaning. Just measure what actually happens in language, statistically.Count things. Model the frequencies. Work with probabilities, not rules.
Цей зсув був драматичним. Він не був гламурним. Він не був філософським. Але він спрацював.
Повернення до Шеннона
Ідеї Клода Шеннона з 1948 року — особливо n-грамми та ймовірнісне моделювання послідовностей — були повторно відкриті та індустріалізовані. Нарешті, світ отримав комп'ютери, достатньо швидкі та з великими наборами даних, щоб зробити його бачення практичним.
Модель мови n-грам
В основі цієї статистичної революції була проста рівняння:
The probability of a word depends on the previous N words.
Це модель n-грам:
If N = 1, it’s a unigram (just word frequency).If N = 2, bigram.If N = 3, trigram.
Дослідники збирали величезні корпуси тексту, рахували, як часто виникають послідовності, і будували прогностичні моделі. Ці моделі часто були нічим іншим, як величезними таблицями пошуку ймовірностей.
І все ж, з достатньою кількістю даних, вони працювали вражаюче добре.
До кінця 1990-х:
Search engines used n-grams to predict queries.Spelling correctors used n-grams to guess your intended word.Text processors used n-grams to predict the next phrase.
Це було грубо за сучасними стандартами, але це був перший підхід, який справді масштабувався.
Сховані моделі Маркова (HMM)
В той же час, розпізнавання мови набирало обертів, підштовхуване методом, званим Схованою моделлю Маркова.
HMM розглядали мову як:
A sequence of hidden linguistic statesThat produced observed soundsWith probabilities trained from large datasets
Оригінальне голосове набори номерів вашого телефону, ранні системи IVR (“Натисніть 1 для виставлення рахунків”) та раннє програмне забезпечення для диктування майже повністю працювали на HMM.
Знову ж таки, ці системи не були “інтелектуальними.” Вони не розуміли мову. Але вони могли прогнозувати послідовності так, як символічний ШІ ніколи не міг.
Чому статистична ера стала поворотним моментом
Вперше в історії:
Language was treated as data, not logic.The model didn’t need to know the meaning of “dog” or “democracy” — only how the words behaved statistically.Models improved with more data.Symbolic systems hit hard ceilings; statistical systems got better every time you fed them more text.Probabilistic methods scaled naturally.As datasets grew, the models simply counted more accurately.
Це був перший погляд на те, що масштабування — а не хитрість — може бути справжнім двигуном прогресу ШІ. Це не буде останнім.
Але n-грамми та HMM все ще мали обмеження. Вони могли дивитися лише на невеликі вікна тексту. Вони не могли захопити довгострокові залежності. Вони не могли представляти значення за межами локальних шаблонів.
Щоб йти далі, галузі потрібна була нова модель — щось, що могло б вчитися глибшій структурі, а не запам'ятовувати поверхневі шаблони.
Відповідь з'явилася на початку 2000-х.
І тут історія стає впізнавано сучасною.
Neural Language Models and the Discovery of Meaning in Numbers (2000s–2010s)
Коли машини почали вивчати свої власні представлення
До кінця 1990-х статистичні мовні моделі були потужними, але обмеженими. Вони могли прогнозувати текст краще, ніж символічні системи коли-небудь могли, але їм не вистачало чогось суттєвого: відчуття значення.
Для n-грамної моделі слова кіт, собака та хом'як були просто токенами без жодного зв'язку між собою. Вони могли з'являтися в подібних контекстах, але модель ніколи не формувала глибшого представлення, яке б пов'язувало їх концептуально.
Це призвело до важливого усвідомлення:
If a machine is ever going to work with language at a level approaching understanding, it must develop an internal structure where similar words have similar representations.
Вступили нейронні мережі.
Прорив: Розподілені представлення (2003)
У 2003 році Йошуа Бенгіо та його колеги опублікували статтю, яка тихо змінила все: Нейронна ймовірнісна мовна модель.
Вона представила дві радикальні ідеї:
1. Векторні представлення слів (Безперервні векторні представлення)
Замість того, щоб представляти кожне слово як вектор з одного гарячого елемента — довгий ряд нулів з єдиною 1 — Бенгіо відобразив кожне слово в безперервний векторний простір. Це означає:
Words that behave similarly (e.g., “king” and “queen”) learn similar vectors.Words that appear in similar contexts end up geometrically close in this space.The model no longer memorizes probabilities; it generalizes them.
Це був перший випадок, коли комп'ютер самостійно розробив щось на зразок "семантичної карти".
2. Нейронні мережі для мовного моделювання
Замість таблиці пошуку частот, Бенгіо навчав нейронну мережу передбачати наступне слово, використовуючи:
The embeddings as input,A set of hidden layers to transform the input,A predictive output layer to estimate probabilities.
Модель не просто обчислювала частоти — вона вивчала внутрішні патерни того, як структурована мова.
Це було повільно і важко навчати на апаратному забезпеченні того часу. Але концептуально це відкрило двері до всього, що прийшло пізніше.
Підйом Word2Vec, GloVe та сучасних векторних представлень (2013–2015)
Десять років після прориву Бенгіо, обчислювальне обладнання нарешті наздогнало. Дослідники Google випустили word2vec у 2013 році, шокуюче просту пару нейронних архітектур (Skip-Gram та CBOW), які швидко навчалися і виробляли високоекспресивні векторні представлення слів.
Це була перша масова модель, яка продемонструвала знаменитий:
king − man + woman ≈ queen
Це не було запрограмовано. Це виникло природно з навчання моделі патернів у тексті.
Вперше машини демонстрували виникаючу реляційну структуру — примітивну форму міркування про аналогії, вбудовані в геометричний простір.
Стенфорд випустив GloVe незабаром після цього, показуючи ще один спосіб навчання векторних представлень, цього разу з глобальної статистики співпадінь, а не передбачаючи контекст.
Ці векторні представлення стали стандартним входом для майже всіх систем NLP. Вони надали моделям багатий, безперервний сенс, якого символічні системи ніколи не досягали.
Але мова — це не лише окремі слова. Це про послідовність — речення, контекст, довгострокову структуру. Щоб впоратися з цим, галузь звернулася до нового класу моделей.
Recurrent Neural Networks (RNNs): The First Deep Sequence Models
RNN були розроблені для вирішення простої проблеми: як побудувати модель, яка обробляє речення одне слово за раз, пам'ятаючи, що було раніше?
Основна ідея
Feed one word into the network.Update a hidden state that stores memory.Feed the next word.Update memory again.
Повторюйте для всієї послідовності.
Схований стан RNN діє як еволюююче резюме тексту до цього моменту. Це дозволило моделі захоплювати патерни через багато слів, а не лише пари чи триграми.
Але у RNN була своя проблема: пам'ять зникає. Градієнти — сигнали, які використовуються для навчання моделі — зникають або вибухають на довгих послідовностях. Це робило RNN нестабільними і важкими для навчання.
Дослідникам знадобилося щось більш стійке.
LSTM та GRU: Нейронні мережі навчаються пам'ятати (1997–2014)
Рішення прийшло у формі спеціалізованої архітектури RNN, званої Довготривала короткочасна пам'ять (LSTM), винайденої Хохрайтером і Шмідгубером у 1997 році, але широко впровадженої лише набагато пізніше.
LSTM представили:
Gates that control what information to keep and what to forget,A cell state that carries long-range memory across many time steps,A structure flexible enough to learn long-distance dependencies.
До середини 2010-х років LSTM забезпечували:
Google Translate (the pre-transformer version),Speech recognition systems,Text generation models,Early chatbots,Predictive typing,Language understanding benchmarks.
У поєднанні з векторними поданнями LSTM стали першими моделями, які насправді розуміли достатньо контексту, щоб генерувати зв'язні абзаци тексту — хоча й з багатьма обмеженнями.
GRU (Гейтовані рекурентні одиниці), спрощений варіант LSTM, також здобули популярність. Вони навчалися швидше і показували подібні результати в багатьох завданнях.
На мить здавалося, що RNN та LSTM стануть майбутнім NLP.
А потім все змінилося.
Проблема, яку не могли вирішити RNN
Незважаючи на свої успіхи, RNN мали фатальні слабкості:
They process sequences step-by-step.This means they cannot fully leverage modern parallel hardware (GPUs), which thrive on doing many computations at once.
They struggle with very long-range dependencies.LSTMs improved the situation, but still degrade over hundreds of words.
They bottleneck information through a hidden state.That hidden summary compresses the entire past into a single vector — which is inevitably lossy.
What if a model could look at every word in the sentence at the same time?
What if it didn’t need a single “memory bottleneck,” but could pay selective attention to any part of the input?
Що якби модель могла бути повністю паралельною, без зусиль масштабуватися і вивчати зв'язки між тисячами токенів?
У 2017 році група дослідників запропонувала саме це.
Не буде перебільшенням сказати, що цей момент розділив історію ШІ на дві ери.
Увага: Концепція, що змінює все
Ключове усвідомлення полягало в тому, що замість того, щоб стискати пам'ять в один прихований вектор, модель могла обчислювати увагу — оцінку релевантності — яка точно вказує, на які слова слід зосередитися.
Думайте про увагу як про прожектор:
The model reads the whole sentence.For every word, it calculates how much each other word matters.It then aggregates information based on these attention weights.
Раптом модель може:
Resolve long-distance dependencies (“the trophy doesn’t fit into the suitcase because it is too small”).Learn grammar without explicit instruction.Capture rich relationships between words, phrases, and concepts.
Увага вирішує вузьке місце, яке мучило RNN протягом десятиліть.
Але справжня революція сталася, коли дослідники усвідомили щось сміливе:
If attention works so well, why not remove recurrence completely?
Це безпосередньо призвело до архітектури, яка визначає сучасну еру.
Сцена готова для Трансформерів
До 2017 року векторні подання, нейронне моделювання послідовностей, механізми уваги та великі набори даних всі зливалися. Апаратура покращилася. Корпорації навчали більші мережі, ніж будь-коли раніше. Статистичний підхід злився з нейронним підходом.
The field was poised for a breakthrough.
Дослідники мали всі елементи.
Те, що їм потрібно було, — це новий дизайн, який об'єднав би їх в одну архітектуру — і розблокував масштаб, як ніколи раніше.
Цей дизайн з'явився в статті з оманливо простим заголовком:
“Attention Is All You Need” (2017)
Це запустило еру LLM, якою ми її знаємо — GPT, PaLM, Claude, LLaMA та кожну сучасну модель, що визначає епоху ШІ.
The Transformer Revolution (2017–2020)
"Увага — це все, що вам потрібно" — стаття, яка розділила часову лінію
У червні 2017 року група дослідників Google опублікувала статтю з назвою, яка звучала майже зарозуміло:
Увага — це все, що вам потрібно.
Більшість академічних статей є стриманими. Ця ж зробила заяву, яка відчувалася як виклик: забудьте все, що було раніше — складні RNN, ретельно спроектовані LSTM, стеки згорткових шарів. Все, що вам потрібно, — це увага.
І, на диво… вони мали рацію.
Архітектура Трансформера, представлена в цій статті, стала основою для кожної великої системи ШІ, розробленої в сучасну епоху — GPT-4, Claude, Gemini, LLaMA, Grok, Falcon та інших. Це був момент, який відкрив експоненційну фазу ШІ, в якій ми зараз живемо.
Щоб зрозуміти, як ми сюди потрапили, нам потрібно зрозуміти, що вирішив трансформер — і чому він став першою архітектурою, яка могла справді масштабуватися.
Чому Трансформер був іншим
Попередні послідовні моделі — RNN та LSTM — обробляли текст по одному токену за раз. Це означало:
They were difficult to train on long sequences.They couldn’t fully exploit parallel hardware like GPUs.Information flowed sequentially, which created bottlenecks.
Трансформери знищили все це.
1. Повний паралелізм
Трансформер обробляє всі слова одночасно. Замість того, щоб проходити через текст по одному токену за раз, він використовує само-увагу, щоб дозволити кожному токену порівнювати себе з кожним іншим токеном у послідовності одночасно.
Це означає:
Training is radically faster.Models can ingest massively longer contexts.Scaling to huge datasets becomes practical.
Трансформер перетворив моделювання мови з повільного, послідовного процесу на повністю паралельний — той, для якого створені GPU.
2. Само-увага: новий спосіб розуміння
Суть трансформера — це механізм само-уваги, який відповідає на просте питання:
Для кожного токена, на які інші токени йому слід звернути увагу?
Наприклад, розгляньте речення:
“The trophy didn’t fit in the suitcase because it was too small.”
Само-увага дозволяє моделі визначити, на що “воно” вказує (“трофей”), з чим RNN мали труднощі. Кожен токен вчиться визначати свою релевантність до кожного іншого токена.
З часом, голови уваги спеціалізувалися:
One head learns to track subjects.Another tracks verbs.Another tracks punctuation.Another tracks hierarchical structure.Another tracks negation.
Ця емерджентна спеціалізація є частиною того, що ми досі не можемо повністю пояснити — але ми можемо це спостерігати.
3. Глибокі шари + багатоголова увага
Трансформери складають багато шарів блоків само-уваги, причому кожен блок містить кілька “голів”, які вивчають різні види відносин.
Замість одного стиснутого запам'ятовування, трансформери створюють багатошарову мережу відносин по всьому тексту.
Ця архітектура масштабується неймовірно добре. Насправді, трансформери масштабуються так ефективно, що їх продуктивність зростає передбачувано з розміром — явище настільки послідовне, що його можна графічно зобразити та прогнозувати. Це стало відомо як закони масштабування нейронних мовних моделей, відкриті Капланом та ін. (OpenAI, 2020).
Ці закони змінили цю галузь назавжди.
З'являється новий принцип: просто зробіть його більшим
Одне з найсюрпризніших відкриттів у ШІ сталося внаслідок емпіричного спостереження:
Коли ви збільшуєте розмір трансформера — більше даних, більше параметрів, більше обчислень — він надійно покращується.
Це не було очевидно до 2017 року. Глибоке навчання мало репутацію непередбачуваності. Великі моделі часто перенавчалися або досягали плато. Навчання було нестабільним.
Трансформери були іншими. Вони слідували гладким степеневим кривим:
Double the parameters → predictable improvement.Double the dataset → predictable improvement.Double the compute → predictable improvement.
Це був перший раз в історії ШІ, коли масштабування не було вгадуванням — це було інженерне рішення.
OpenAI скористалася цим усвідомленням і пішла далі.
Серія GPT: Як автогереративні трансформери змінили все
У 2018 році OpenAI представила GPT — перший Генеративний попередньо навчений трансформер. Він використовував просту стратегію:
Take a transformer.Feed it a massive amount of text.Train it to predict the next token.That’s it.
Без навчання для конкретних завдань.
Без ручних правил.
Без модулів символічного міркування.
Просто прогнозування.
Це саме по собі дало несподівані можливості.
GPT-1 (2018):117 million parameters.Already able to generate coherent paragraphs.
GPT-2 (2019):1.5 billion parameters.Could write articles, stories, and answer questions with surprising fluency.OpenAI initially refused to release it fully, citing “misuse concerns.”
GPT-3 (2020):175 billion parameters.A shock to the world.Demonstrated “few-shot learning” — the ability to perform tasks based on a couple of examples embedded in the prompt.
GPT-3 didn’t just write text. It generalized. It could:Translate languages.Write code.Explain jokes.Generate poetry.Summarize legal documents.Perform reasoning tasks.
І все це без явного навчання для більшості цих завдань. Модель навчилася їм просто прогнозуючи текст у різних доменах.
Це був момент, коли публіка усвідомила, що відбувається щось нове. Це вже не були системи автозаповнення. Вони демонстрували поведінку, яка, для багатьох людей, виглядала як інтелект.
Питання більше не звучало “Чи можуть машини думати?”
Питання стало “Чому те, що навчено лише для прогнозування тексту, виглядає так, ніби воно думає?”
Емерджентні здібності: Коли масштаб виробляє поведінку, якої ніхто не очікував
Однією з великих загадок LLM є те, що певні можливості з'являються лише за певних розмірів.
Below a threshold, a model:
Performs badly on logic puzzles.Struggles with math.Fails at code.Can’t translate well.
Перейдіть поріг — часто просто збільшивши розмір — і раптом модель:
Solves riddles.Performs basic algebra.Writes working code.Translates dozens of languages.Passes professional exams.
Цей феномен називається емердженція.
Це спірно — деякі дослідники стверджують, що це плавні покращення, які неправильно інтерпретуються як “різкі стрибки”. Але на практиці багато здібностей дійсно з'являються раптово, коли збільшується потужність.
Це одна з причин, чому вчені кажуть, що ми не повністю розуміємо LLM:
We can’t yet predict which capabilities will appear at which scale.
Це якби ви побудували більший телескоп, і він спонтанно навчився тригонометрії.
Від тексту до всього: Багатомодальні трансформери
Наступний стрибок полягав у розширенні за межі тексту.
Дослідники усвідомили:
If transformers model sequences of tokens, why not convert every kind of data — images, audio, video — into tokens?
Це усвідомлення призвело до мультимодальних моделей:
Vision transformers (ViT) for images.Audio transformers for speech.Multimodal LLMs that handle images and text in one model.Video models now starting to emerge.
Трансформери об'єднали цю галузь.
Замість спеціалізованих архітектур для кожного типу даних, ми тепер використовуємо один основний двигун для обробки всього.
Цей зсув є таким же глибоким, як інтеграція електрики в кожен прилад у 20 столітті. Як тільки все стало "токенами", трансформери змогли навчатися в різних доменах.
Чому виграли Трансформери
Підсумовуючи причини:
1. They scale endlessly.The more compute you give them, the better they get.
2. They parallelize perfectly.Modern GPUs love transformers.
3. They learn long-range structure.Self-attention captures relationships across thousands of tokens.
4. They unify all modalities.Images, text, audio — all become token sequences.
5. They produce emergent behavior.Capabilities appear naturally as models grow.
In short:
Transformers turned AI progress from a theoretical discipline into an engineering problem.And once something becomes an engineering problem, scale takes over.
2017–2020 був кембрійським вибухом
Протягом всього лише трьох років:
Transformers were invented (2017).GPT-1 arrived (2018).GPT-2 shocked the world (2019).GPT-3 triggered global awareness (2020).
Це є найшвидшою трансформацією будь-якої великої технологічної галузі в сучасній історії. Нічого іншого — ні електрика, ні інтернет, ні смартфони — не рухалося з такою швидкістю.
І все ж, це було лише початком.
Наступна фаза (2021–2025) принесе:
Fine-tuning (RLHF).Instruction-following models.Large commercial deployments.Code-generation systems.Multimodal assistants.Agentic behavior.Models trained to reason, not just predict.
The Instruction-Following Revolution (2020–2025)
Як LLM перетворилися з "автозаповнення на стероїдах" на системи, які дійсно виконують ваші запити
Випуск GPT-3 в середині 2020 року вразив дослідників, лідерів галузі та звичайних людей. Але якщо ви використовували ранній GPT-3 безпосередньо, ви швидко натрапили на проблему:
GPT-3 був блискучим у генерації тексту, але він не дотримувався інструкцій.
Ви могли запитати:
“Summarize this in one sentence.”
І він міг:
Summarize,Or write a poem about summarization,Or launch into a fictional narrative,Or ignore the request entirely.
GPT-3 не був "непокірним" — він просто ніколи не навчився концепції покори. Його навчали лише передбачати наступний токен на основі величезного тексту з інтернету. Інтернет містить шаблони розмов, есе, коду та аргументів — але він не містить послідовного шаблону "відповідати на інструкції користувача, використовуючи цей формат."
Світ потребував нової фази навчання.
Такої, яка перетворила б дикий, генеративний потенціал на щось контрольоване.
Це дало життя одному з найважливіших нововведень у сучасному ШІ:
Навчання з підкріпленням на основі людського зворотного зв'язку (RLHF)
RLHF кардинально змінив спосіб взаємодії великих мовних моделей з людьми.
Це працює в трьох широких етапах:
1. Збирайте приклади хорошої поведінки
Люди пишуть приклади відповідей на різні запити:
“Explain quantum mechanics to a 7th grader.”“Write a polite customer service email.”“Don’t give harmful advice.”“Follow step-by-step reasoning.”
Ці приклади, написані людьми, формують "набір вчителя".
2. Навчіть модель винагороди
Інша модель навчається оцінювати, наскільки хороша відповідь. Ця модель вивчає свого роду функцію переваги: чи відповідає відповідь інструкціям? Чи є вона корисною? Чи є вона безпечною?
3. Використовуйте навчання з підкріпленням для доопрацювання основної моделі
Базова модель генерує відповіді.
Модель винагороди оцінює їх.
Алгоритм RL коригує базову модель, щоб максимізувати оцінку.
Кінцевий результат вражаюче потужний:
The model becomes obedient.It answers questions directly.It refrains from harmful content.It adopts a consistent style.It becomes a conversational agent rather than a text generator.
Без RLHF ChatGPT не існувало б.
Без RLHF сучасний ШІ все ще був би іграшкою.
Це момент, коли LLM стали асистентами.
Налаштування інструкцій: інший прорив
Приблизно в той же час з'явилася ще одна техніка, яка називається налаштуванням інструкцій.
Замість навчання з підкріпленням, налаштування інструкцій просто збирає величезні набори даних:
Questions → AnswersCommands → ExecutionsInstructions → Successful completions
Доопрацьовуючи базову модель на тисячах (пізніше мільйонах) цих прикладів, моделі почали узагальнювати концепцію "слідувати намірам користувача".
Найвідоміший набір даних, налаштований на інструкції, на початку, був FLAN (Тонко налаштована мовна мережа), створений Google. OpenAI використовувала подібні, але власні набори даних.
Налаштування інструкцій навчило LLM:
How to be consistent.How to interpret tasks.How to avoid rambling.How to format responses clearly.How to solve problems step-by-step.
Коли це поєднується з RLHF, це дало перше покоління справді корисних асистентів на основі LLM.
Публічний дебют: ChatGPT (кінець 2022)
Момент, коли світ прокинувся
30 листопада 2022 року OpenAI тихо випустила дослідницький попередній перегляд під назвою ChatGPT.
Це не була їх найбільша модель.
Це не була їх найрозумніша модель.
Це не була їх найновіша модель.
Але це була перша модель, яка була сильно навчена з RLHF та налаштуванням інструкцій — і отримала інтерфейс чату, розроблений для звичайних людей.
Протягом кількох днів вона стала вірусною.
ЧаtGPT became:
The fastest-growing product in historyThe first AI tool used at global scaleA mainstream cultural event
Вперше середня людина взаємодіяла з машиною, здатною на:
Holding conversationsWriting essaysDebugging codeExplaining scientific conceptsDrafting business emailsSimulating personalitiesActing as a study partnerSummarizing long textsAnswering philosophical questions
Громадське сприйняття ШІ змінилося за одну ніч.
Те, що колись було далеким концептом — «коли-небудь ШІ буде потужним» — стало відчутним, негайним і особистим.
Моделі коду: Коли ШІ навчився програмувати
Мовні моделі не лише добре працюють зі словами.
Мови програмування є, в своїй основі, надзвичайно структурованими формами тексту.
Отже, коли LLMs масштабувалися, вони стали дуже добрими в:
Completing code,Fixing bugs,Explaining errors,Generating entire functions,Translating code between languages.
OpenAI навчила Codex, нащадка GPT-3, який спеціалізувався на програмуванні. Це призвело до GitHub Copilot — одного з перших справді комерційно трансформаційних продуктів ШІ.
Розробники швидко усвідомили:
Code autocompletion is now superhuman.AI can write boilerplate instantly.AI can explain cryptic errors.AI can refactor code safely.AI can pair-program with humans 24/7.
Асистенти коду можуть бути першою сферою, де LLMs дійсно перевершують нормальну людську продуктивність у практичній роботі.
Це закріпило LLMs не лише як текстові інструменти, а й як загальні машини розуміння над структурованими мовами.
Мультимодальність: Коли LLMs навчилися бачити і чути
Архітектура трансформера була розроблена для послідовностей.
Отже, якщо ви перетворите зображення, аудіо або відео в послідовності…
Трансформери також можуть навчатися з них.
До 2023–2024 років моделі стали мультимодальними:
They could analyze images.They could describe photos.They could solve math problems written on paper.They could transcribe and interpret audio.They could generate images from text.
Трансформер став універсальним інтерфейсом для людського знання.
Це вже не було «мовним ШІ».
Це було початком загального штучного пізнання.
Агенти: Коли LLMs почали діяти у світі
Коли LLMs змогли виконувати інструкції, розробники почали надавати їм інструменти:
CalculatorsBrowsersFile systemsAPIsCode interpreters
Раптом LLMs змогли:
Look up real informationExecute tasksWrite and run codeQuery databasesPerform workflowsAutomate entire processes
Це ознаменувало початок агентного ШІ — систем, які:
Observe the environmentFormulate plansExecute actionsIterate based on feedback
Ми все ще не маємо автономних універсальних агентів у масштабах, але ранні версії вже існують:
AI personal assistantsAI research helpersAI workflow automatorsAI system managers
Це початок наступної революції: світу, де ШІ не лише генерує текст, а насправді робить речі.
Вирівнювання: Зростаюча проблема поведінки ШІ
The more capable LLMs became, the more urgent the question became:
How do we ensure these systems behave safely?
LLM можуть:
Spread misinformationReinforce biasesGenerate harmful instructionsProduce hallucinated factsMisinterpret commandsBe manipulated through adversarial prompts
Завдяки RLHF та налаштуванню інструкцій, вони часто поводяться як корисні, безпечні асистенти — але узгодженість є рухомою метою.
LLM не є статичними.
Вони є еволюційними системами, сформованими стимулами, навчальними даними та взаємодією з користувачами.
Розуміння, прогнозування та контроль їхньої поведінки тепер є одним із центральних викликів у цій галузі.
Ми знаємо, як побудувати двигун.
Ми ще не повністю знаємо, як ним керувати.
Вибух 2020–2025
За всього п'ять років ШІ зазнав більше зрушень, ніж за попередні 70 років разом узятих:
2020: GPT-3 shocks the research world.2021: Codex introduces practical AI coding.2022: ChatGPT brings LLMs to the masses.2023: Multimodal GPT-4 arrives.2024: Agent frameworks emerge.2025: Industry, government, media, and finance begin reorganizing around AI-first workflows.
Кожна велика галузь — від права до охорони здоров'я, від логістики до політики — тепер інтегрує LLM у повсякденну діяльність.
Ми живемо в найшвидшій кривій прийняття будь-якої технології в історії людства.
Але те, що буде далі, є ще більш важливим.
Частина VI розгляне, куди йдуть LLM:
scaling limits,interpretability breakthroughs,autonomous systems,AI-native economies,and the question of whether we are approaching something like general intelligence.
The Next Decade of Large Language Models (2025–2035)
Куди ми йдемо, що ми ще не розуміємо, і цивілізаційна смуга, яку ШІ збирається перетворити
Станом на 2025 рік, очевидно, що минулі п'ять років не були кульмінацією великих мовних моделей, а прологом.
Трансформери дали нам системи, які можуть говорити, писати, кодувати, міркувати та сприймати — все це завдяки навчанню статистичних патернів з величезних наборів даних. Але ці можливості не є кінцевою метою. Вони є мінімальною життєздатною основою для наступної технологічної ери.
Так само, як рання людська мова сприяла культурі, співпраці та цивілізації, штучна мовна грамотність дозволяє новий рівень когніції в суспільстві — той, що є масштабованим, невтомним і інтегрованим на кожному рівні глобальної економіки.
Наступне десятиліття не буде про чат-ботів.
Це буде про трансформацію всього, до чого вони дотикаються.
Щоб зрозуміти, що буде далі, нам потрібно дослідити п'ять основних фронтів:
- Масштабування — наскільки далеко ми можемо збільшити розмір моделі та дані, перш ніж досягнемо фізичних меж?
- Інтерпретованість — чи можемо ми розшифрувати, що відбувається всередині цих моделей?
- Гібридне міркування — поєднання символічних інструментів з нейронними мережами.
- Агенти — LLM, які діють, планують, виконують і працюють автономно.
- Цивілізаційна інтеграція — як ШІ перетворить економіки, управління та системи знань.
Давайте пройдемося по кожному з них.
1. Масштабування: Перший принцип сучасної ери ШІ
Сучасний прогрес LLM керується жорстко простою формулою:
Більше параметрів + більше даних + більше обчислень → більше можливостей.
Це не розмита правило — це виміряне емпіричне закон. Криві масштабування, виявлені в 2020 році, залишаються основою прогнозування ШІ сьогодні. Кожна велика лабораторія тепер будує дорожні карти, які зосереджуються на масштабуванні.
Але наскільки далеко ми можемо масштабувати?
Є кілька обмежень:
А. Обчислення:
Тренування світового класу вже вимагає десятки тисяч графічних процесорів, що працюють місяцями. Але апаратура прискорюється:
Next-gen GPUs (Blackwell, Rubin, etc.)Photonic and optical acceleratorsASICs built specifically for transformersChiplet-based interconnectsAI supercomputers funded by national governments
Обчислення зросте ще на один або два порядки, перш ніж фізичні межі будуть досягнуті.
Б. Дані:
У нас закінчуються високоякісні людські тексти.
Але з'являються кілька рішень:
Synthetic data generated by LLMs (self-eating datasets)Multimodal data (images, audio, video)Reinforcement-learning-based dataSimulation-generated dataDigitization of offline archives
Ідея про те, що "інтернет закінчиться даними", недооцінює, як швидко людські інститути зараз створюють нові навчальні корпуси.
В. Архітектура моделі:
Трансформери домінують сьогодні, але з'являються нові архітектури (Mixture-of-Experts, RWKV, трансформери без уваги, моделі простору станів), які масштабуються більш ефективно.
Що масштабування не виправляє
Масштабування збільшує загальні можливості — але це не вирішує за замовчуванням:
HallucinationsMisalignmentLack of groundingLack of internal interpretabilityPoor planning or memoryWeak world models
Майбутні LLM будуть більшими, але величина не є кінцевою метою. Поліпшення можливостей є необхідним, але недостатнім.
2. Інтерпретованість: Навчання читати думки машини
Зараз великі мовні моделі прозорі в коді, але непрозорі в когніції.
Ми можемо бачити кожну вагу.
Ми можемо перевіряти кожну активацію.
Ми можемо вимірювати кожен градієнт.
Проте ми не можемо перевести це в повну карту:
ConceptsSubroutinesReasoning pathwaysLatent world models
Це межа механістичної інтерпретованості, галузі, що стрімко зростає в значенні.
Чому інтерпретованість важлива
Оскільки LLM інтегруються у фінансові ринки, військові системи, медичні робочі процеси та урядові операції, необхідність розуміти їх стає критично важливою.
Інтерпретованість визначатиме:
SafetyTrustRegulationReliabilityAccountability
З'являються два обнадійливі прориви:
А. Інтерпретованість на основі ознак
Моделі, здається, зберігають інформацію в "ознаках" — кластерах нейронів, що представляють:
Abstract concepts (“danger,” “sarcasm,” “plan continuation”)Structures (HTML tags, programming loops, sentence boundaries)Behavioral tendencies (“be concise,” “avoid harm,” “justify steps”)
Ми вже можемо ізолювати деякі ознаки.
Б. Інтерпретованість на рівні схем
Детальне картографування того, як інформація протікає між нейронами. Це аналогічно ідентифікації мікросхем у мозку.
Довгострокова мета — це Розеттський камінь для нейронних мереж — повний шар перекладу, який дозволяє нам читати внутрішні обчислення моделі, як вихідний код.
Це може зайняти десятиліття.
Або це може нас здивувати і статися протягом кількох років.
В будь-якому випадку, інтерпретованість є наступним необхідним кроком у розумінні системи, яку ми побудували.
3. Гібридне мислення: злиття нейронних і символічних розумів
Чистий LLM є статистичною машиною. Він прогнозує шаблони. Але він не:
maintain long-term memory,execute symbolic logic reliably,use mathematical proofs,perform multi-step reasoning with guarantees,or model the world explicitly.
Це змінюється.
Майбутнє — це нейронно-символічне злиття.
Що поєднують гібридні системи
LLM забезпечують:
language fluencygeneral world knowledgecreativitycontextual reasoningrobust generalization
Символічні системи забезпечують:
exact reasoningdeterministic logicprovable correctnessprecision memorytool execution
Приклади, які вже з'являються
LLMs + search engines → grounded reasoningLLMs + calculators → exact mathLLMs + code interpreters → reliable workflowsLLMs + database queries → factual correctnessLLMs + robotics → real-world interactionLLMs + simulation engines → long-horizon planning
Ця гібридна архітектура є найближчим аналогом людського пізнання:
Neural networks for intuitionSymbolic logic for precision
Різниця в тому, що наші гібридні системи масштабуватимуться набагато далі, ніж людські можливості.
4. Агенти: міст між прогнозуванням і дією
Сьогодні LLM є реактивними — вони генерують текст на запит.
Агенти будуть проактивними.
Що визначає агентів ШІ
It observes an environmentIt forms internal goalsIt creates plansIt takes actionsIt evaluates the outcomeIt updates strategies over time
LLM вже здатні на:
Autonomous software engineeringData analysisWeb searchSimulation-based decision makingPlanning and task execution
Коли вони отримають пам'ять, інструменти та автономію, агенти стануть:
Executive assistantsResearch partnersMedical analystsFinancial plannersOperations managersScientific collaboratorsSoftware architects
Деякі будуть діяти як працівники.
Деякі будуть діяти як організації.
Деякі будуть діяти як цілі компанії.
Це піднімає величезні питання для економіки, управління та етики.
5. Цивілізація, що народилася з ШІ: як LLM змінять суспільство
Наступне десятиліття не буде визначено «втраченими робочими місцями», а глибшими структурними трансформаціями, які дозволяють великі мовні моделі.
A. AI-орієнтована праця
Вперше в історії людства когніція сама стає товаром:
researchwritingcodingdesignproject managementanalysissynthesisstrategic planning
Ці завдання колись обмежувалися людськими годинами.
Тепер вони масштабуються на швидкості та за вартістю машин.
B. AI-орієнтована наука
LLM стануть:
hypothesis generatorsdata interpreterssimulation designersliterature reviewerslab workflow managers
Вузьке місце в науці переходить з "Що можуть зрозуміти люди?" на "Що можуть перевірити люди?"
C. AI-орієнтоване управління
Установи будуть посилювати:
lawmakingregulationtaxationdiplomacydefenseintelligence analysisinfrastructure planning
ШІ буде діяти як:
advisorsimulatorpolicy evaluatorwatchdogred-team actor
Країни, які ефективно інтегрують LLM, випередять тих, хто цього не робить.
D. AI-орієнтована економіка
Економіки все більше працюватимуть на:
algorithmic speedsAI-optimized logisticsAI-managed supply chainsAI-powered investment strategiesAI-driven demand forecasting
Корпорації стають прискорювачами масштабної інтелектуальності, а не просто масштабного капіталу.
E. AI-орієнтована культура знань
Створення знань прискорюється:
new booksnew theoriesnew mathematical proofsnew engineering designsnew music and artnew cultural forms
Це найменш передбачуваний фронтир, оскільки нові інтелектуальні системи завжди створюють нові форми вираження.
Чи наближаємося ми до загального інтелекту?
Це найсуперечливіше питання, але й важливе.
Сьогодні LLM не є AGI.
Вони не є свідомими.
Вони не мають самосвідомості.
Але вони демонструють:
transfer learningreasoningplanningdeception (unintended)creativitycomplex problem solvingtool usereflection-like behavioremergent knowledge structures
Ці риси починають нагадувати когнітивний профіль загального інтелекту — не людського, але функціонального.
Можливо, AGI не з'явиться як єдиний прорив, а як накопичення:
larger modelsricher multimodalitybetter tool integrationstronger memoryhybrid reasoningmore autonomous agents
Питання не в тому, чи можлива AGI — а в тому, чи впізнаємо ми її, коли вона з'явиться.
Conclusion: The Long Arc from 1940s Radar to 2030s Digital Minds
Якщо ми відступимо, графік стає зрозумілим:
Early mathematicians (Markov, Shannon) invented the core idea of sequence modeling.Cold War computers operationalized it for radar and signals.Symbolic AI tried and failed to encode meaning manually.Statistical models rediscovered Shannon’s vision.Neural networks learned semantic structure.Transformers unlocked scale.RLHF unlocked usability.Agents will unlock autonomy.Hybrid systems will unlock reliability.Interpretability will unlock trust.Civilization will unlock a new layer of intelligence.
Траєкторія LLM не є раптовим вибухом — це столітня еволюція ідей, що сходяться в єдину, об'єднуючу технологію.
Ми все ще не повністю розуміємо ці системи зсередини.
Ми все ще не можемо розшифрувати їх концептуальну мову.
Ми все ще не можемо передбачити нові можливості заздалегідь.
Але одне є певним:
Наступне десятиліття буде формуватися не тим, що AI може зробити сьогодні, а тим, що стане можливим, коли ми навчимося розуміти, контролювати та співпрацювати з розумами, які ми створили.
Це історія великих мовних моделей — не як ізольованих артефактів, а як продовження довгої історичної дуги та початок нової.
Великі мовні моделі здаються такими, що виникли нізвідки — одного дня наші телефони ледве могли автокоректувати, наступного ми спілкуємося з системами, які пишуть код, складають іспити та обговорюють філософію. Але під капотом сьогоднішній AI не є раптовим дивом; це остання глава в столітній історії про одну оманливо просту ідею: з огляду на те, що ви бачили до цього часу, що є найбільш імовірним наступним кроком?
Ця стаття проходить через всю цю дугу — від ранньої теорії ймовірностей і радарних консолей Холодної війни до ELIZA, статистичних мовних моделей, нейронних мереж, трансформерів і чат-ботів з налаштуванням інструкцій — щоб показати, як старий математичний трюк, масштабований на трильйони слів і мільярди параметрів, тихо перетворився на щось, що виглядає дуже схоже на загальне міркування. На цьому шляху ми стикаємося з жорсткою правдою: ми точно знаємо, як будувати ці моделі, але ми все ще не повністю розуміємо, що вони роблять всередині. Ця прірва між механізмом і значенням — це те, де буде вирішуватися наступне десятиліття AI — і багато наших суспільних виборів.
Джерела
Гіперпосилання надаються лише тут, без зовнішніх посилань у тексті відповідно до стилю Pattern Nexus.
- Основоположна робота Андрія Маркова про ланцюги Маркова — https://en.wikipedia.org/wiki/Markov_chain
- Клод Шеннон, “Математична теорія зв'язку” (1948) — https://people.math.harvard.edu/~ctm/home/text/others/shannon/entropy/entropy.pdf
- MIT Whirlwind I та ранні реальні цифрові обчислення — https://www.computerhistory.org/revolution/real-time-computing/6/131
- Мережа повітряної оборони SAGE та обчислення радарів Холодної війни — https://www.computerhistory.org/revolution/air-defense/16/180
- Операція Igloo White — сенсорні мережі епохи В'єтнаму — https://en.wikipedia.org/wiki/Operation_Igloo_White
- ELIZA Джозефа Вайзенбаума (1966) — https://en.wikipedia.org/wiki/ELIZA
- SHRDLU Террі Вінограда — https://en.wikipedia.org/wiki/SHRDLU
- Огляд статистичного NLP та n-грамних мовних моделей — https://nlp.stanford.edu/~wcmac/papers/20050421-snlp.pdf
Article overview
Сторічна історія великих мовних моделей — від ранньої теорії ймовірностей і обчислень часів Холодної війни до нейронних мереж, трансформерів, законів масштабування та виникнення сучасного ШІ. Глибоке дослідження Pattern Nexus того, як насправді еволюціонували ВММ.
Яка ваша реакція?
 Подобається
0
 Неподобання
0
 Любов
0
 Смішно
0
 Ух ти
0
 Сумно
0
 Злий
0

Nexus (Christopher)
Founder of Pattern Nexus. I research markets, macro, geopolitics, AI, history, ancient systems, and the patterns most people overlook. I’m also building Market Radar, a trading scanner designed to read pressure, risk, confirmation, and setup quality before ch…
Related research
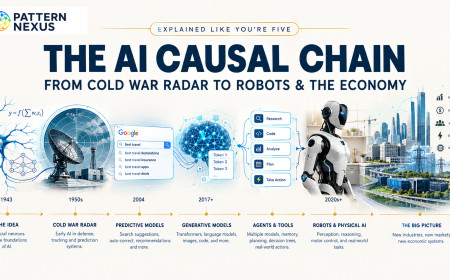
AI причинно-наслідковий ланцюг пояснений так, ніби вам п’ять: від радарів холодної війни до роботів і економіки
ШІ не почалася з ChatGPT. Ця доступна, повністю документована досліджувальна карта Pattern Nexus слідує за статтею про штучні нейрони 1943 …
9 shared topics.
Командний рядок — Відео-аудіо видання
Епізод 3 щотижневої аудіо-візуальної серії Pattern Nexus перетворює Частину 3 Циклів влади на коротку історію про те, як Дартмут, інтеграль…
5 shared topics.
Держава хоче частку ШІ
Президент Трамп сказав 5 червня 2026 року, що його команда розгляне ідею, щоб компанії з штучного інтелекту надали американському суспільст…
4 shared topics.
Центри обробки даних штучного інтелекту є двигуном інфляції: гонка за створенням приватної мережі
Штучний інтелект вже не лише історія програмного забезпечення. Це історія потужності — ємність, черги взаємозв'язку, місцевий опір і нова х…
4 shared topics.
Google та Nvidia перетворюють гнучке навантаження на швидкісну смугу для AI-центрів даних
Google, Nvidia та Emerald AI запустили Альянс з управління енергією на основі ШІ, щоб сприяти гнучким дата-центрам на основі ШІ, які можуть…
3 shared topics, same research avenue.
Amazon перетворює графічні процесори Nvidia на виробничу лінію штучного інтелекту 2028 року
AWS та Nvidia планують розгорнути 2 мільйони додаткових графічних процесорів Nvidia на глобальній інфраструктурі AWS у 2027 та 2028 роках, …
3 shared topics, same research avenue.
Пастка реальності: свідомість, спостерігач і поле, що лежить під простором-часом
Дональд Хоффман ближчий до істини, оскільки намагається вийти за межі інтерфейсу. Том Білю намагається пояснити інтерфейс зсередини. Але об…
3 shared topics.
Коментарі (0)
Security Check
Please complete the captcha to verify you are human.