

ذہانت کا ایک طویل قوس: کس طرح 80 سال کی انجینئرنگ نے جدید LLMs تخلیق کیے
ایک صدی کی طویل تاریخ بڑی زبان کے ماڈلز کی—ابتدائی احتمال کے نظریات اور سرد جنگ کی کمپیوٹنگ سے لے کر نیورل نیٹ ورکس، ٹرانسفارمرز، اسکیلنگ قوانین، اور جدید AI کے ابھار تک۔ LLMs کی حقیقی ترقی کی ایک گہ…
Jump to a section
Introduction: The Machines That Predict Us
زیادہ تر لوگوں نے پچھلے چند سالوں میں پہلی بار بڑے زبان ماڈلز کا سامنا کیا — عام طور پر ایک چیٹ ونڈو کی شکل میں جو ایک دن جاگ گئی اور بات کرنا شروع کر دیا۔ تقریباً ایک رات میں، ایسا سافٹ ویئر جو آپ کی ہجے کو درست کرنے میں بھی مشکل محسوس کرتا تھا، اچانک کوڈ لکھنے، عدالت کے مقدمات کا خلاصہ کرنے، لائسنسنگ کے امتحانات پاس کرنے، اور ایسی گفتگو کرنے لگا جو غیر معمولی طور پر انسانی محسوس ہوتی تھی۔ یہ سائنس فکشن کی طرح روزمرہ کی زندگی میں پھٹتا ہوا نظر آیا۔
لیکن حقیقت اس سے کہیں زیادہ عجیب ہے۔ یہ نظام کہیں سے نہیں آئے۔ یہ ایک خیال کا جدید اظہار ہیں جو خود ڈیجیٹل کمپیوٹرز سے بھی قدیم ہے — ایک خیال جو ابتدائی احتمال کے نظریے، جنگ کے دوران سگنل انٹیلی جنس، اور معلومات کے بہاؤ کو رسمی شکل دینے کی پہلی کوششوں سے پیدا ہوا۔ کچھ طریقوں سے، چیٹ جی پی ٹی کا علمی آباؤ اجداد کوئی اور سافٹ ویئر نہیں ہے، بلکہ سرد جنگ میں ایک ریڈار کنسول ہے۔
آج کی AI کے پیچھے بنیادی چال حیرت انگیز طور پر سادہ ہے: پیش گوئی۔ جو کچھ پہلے آیا ہے، اس کے پیش نظر، اگلا کیا آنے کا سب سے زیادہ امکان ہے؟ جملہ مکمل کریں۔ پیٹرن کو جاری رکھیں۔ سگنل کو بڑھائیں۔ یہی اصل ہے۔ باقی سب کچھ پیمانہ، انجینئرنگ، اور پیکجنگ ہے۔
پھر بھی، ان نظاموں کی تعمیر کے بارے میں بالکل جاننے کے باوجود — ہر کوڈ کی لائن، ہر ریاضیاتی عمل، ہر تربیتی الگورڈم — ہم ابھی تک مکمل طور پر وضاحت نہیں کر سکتے کیوں وہ اتنی اچھی طرح کام کرتے ہیں۔ ہم مشینری کو سمجھتے ہیں، لیکن ہم اندرونی نمائندگیوں کو مکمل طور پر نہیں سمجھتے جو اندر ترقی پذیر ہوتی ہیں۔ یہ احتمال کے مصنوعی جاندار ہیں، جو ٹریلین الفاظ کے سامنے آنے سے تشکیل پاتے ہیں، ایسے پیٹرن کے ساتھ دھڑکتے ہیں جنہیں ہم ناپ سکتے ہیں لیکن مکمل طور پر ترجمہ نہیں کر سکتے۔
یہ مقالہ اس ٹیکنالوجی کو واضح کرنے کی کوشش ہے، طویل، مسلسل کہانی بیان کرتے ہوئے: 1900 کی دہائی میں ابتدائی احتمال کے پہیلیوں سے، سرد جنگ کے فضائی دفاعی کمپیوٹرز تک جو بنیادی طور پر ابتدائی تسلسل ماڈلنگ کرتے تھے، 1960 کی دہائی میں قاعدہ پر مبنی AI کی تبدیلی، 1990 کی دہائی کے شماریاتی انقلاب، 2000 کی دہائی کے نیورل نیٹ ورکس، اور آخر میں اس ٹرانسفارمر آرکیٹیکچر تک جو آج کے LLMs کو ممکن بناتا ہے۔
کہانی اچانک ذہانت کی نہیں ہے۔ یہ پیمانے، دوبارہ دریافت، بھولے ہوئے خیالات، اور ماڈلز کو بڑا کرنے اور انہیں مزید ڈیٹا فراہم کرنے کے غیر متوقع نتائج کی کہانی ہے۔ سب سے اہم بات یہ ہے کہ یہ ایک ایسے ٹول کی کہانی ہے جس کے ڈیزائنرز ہڈ کھول سکتے ہیں اور ہر جزو کی وضاحت کر سکتے ہیں، پھر بھی ابھرتی ہوئی ذہانت کی وضاحت کرنے میں جدوجہد کرتے ہیں جو اندر دھڑکتی ہے۔
اس مقالے کے آخر تک، ایک اوسط قاری کو نہ صرف یہ سمجھنا چاہیے کہ بڑا زبان ماڈل کیا ہے، بلکہ یہ بھی کہ ماہرین خود کبھی کبھار ایمانداری سے کہتے ہیں کہ ہم مکمل طور پر نہیں جانتے کہ اندر کیا ہو رہا ہے۔
What a Language Model Actually Is
تاریخ میں جانے سے پہلے، آئیے ہائپ کو کاٹتے ہیں۔ زبان ماڈل کیا ہے؟
لفظ "ذہانت" کو بھول جائیں۔ روبوٹ، شعور، یا سائنس فکشن کی تشبیہات کو بھول جائیں۔ اس کی بنیادی حیثیت سے، ایک زبان ماڈل صرف ایک احتمالی انجن ہے جو ایک تسلسل کے اگلے عنصر کی قیاس کرنے کے لیے تربیت یافتہ ہے۔
الفاظ، کردار، ٹوکن — یہ اہم نہیں ہے۔ مشین ایک جزوی تسلسل کو دیکھتی ہے اور یہ طے کرتی ہے کہ کیا ممکن ہے کہ اس کے بعد کیا آئے گا۔ پھر یہ ایک کو منتخب کرتی ہے اور عمل کو دہرائی کرتی ہے، بار بار، جب تک کہ آپ اسے رکنے کے لیے نہ کہیں۔ بس اتنا ہی۔
اگر میں ایک جملہ شروع کروں:
The sky turned dark as the storm…
آپ شاید اسے مکمل کر سکتے ہیں: نزدیک ہوا، گھوم گیا، تشکیل دیا، وغیرہ۔ آپ کا دماغ ہر طوفان کی تفصیل سے جو آپ نے کبھی سنا ہے، کے پیٹرن کی بنیاد پر احتمال کا حساب لگا رہا ہے۔
ایک زبان ماڈل کچھ ایسا ہی کرتا ہے، لیکن اس پیمانے پر جسے انسانی دماغ نہیں چھو سکتا۔ اگر آپ نے ایک مشین کو ہر کتاب پر تربیت دی جو کبھی ڈیجیٹائز کی گئی، ہر وکیپیڈیا کا مضمون، ہر خبر کی کہانی، ہر فورم کا تھریڈ، ہر بلاگ، ہر کوڈ کی لائن جو GitHub پر ہے — ٹریلین الفاظ — تو یہ انسانی تحریر، استدلال، بحث، وضاحت، اور کہانیاں سنانے کے طریقے کی شماریاتی ساخت کو اندرونی طور پر سمجھنا شروع کر دے گی۔ یہ معنی کو اس طرح نہیں سمجھتا جیسے ہم کرتے ہیں، لیکن یہ معنی کے پیٹرن کو پکڑتا ہے، جو اکثر ذہین نظر آنے کے لیے کافی ہوتا ہے۔
سادہ الفاظ میں:
LLMs سوچ نہیں رہے ہیں؛ وہ گہرائی، عمیق، ناقابل تصور طور پر پیش گوئی کر رہے ہیں۔
لیکن اس سے ایک سوال پیدا ہوتا ہے: اگر یہ میکانزم اتنا سادہ ہے، تو نتائج اتنے پیچیدہ کیوں محسوس ہوتے ہیں؟
جواب پیمانے میں ہے۔ پیٹرن جو چھوٹے سائز میں کمزور، ٹوٹے ہوئے، یا نظر نہیں آتے، جب ماڈل کو بڑے ڈیٹا کے سامنے لایا جاتا ہے اور اسے اپنی اندرونی ساخت کو ایڈجسٹ کرنے کے ٹریلین مواقع دیے جاتے ہیں تو وہ امیر اور ہم آہنگ ہو جاتے ہیں۔ کچھ ابھرتا ہے — نہ شعور، بلکہ قابلیت۔ نہ سمجھنا، بلکہ ایسا رویہ جو اس کی نقل کرتا ہے۔
The Strange Problem of Knowing and Not Knowing
یہاں ایک متضاد صورتحال ہے جو عوام کو الجھن میں ڈال دیتی ہے: AI محققین کہتے ہیں کہ انہیں معلوم ہے کہ کیسے LLMs کام کرتے ہیں لیکن انہیں کیوں یہ کام کرتے ہیں، اس کا علم نہیں۔ یہ ہاتھ ہلانے جیسا لگ سکتا ہے، یا یہاں تک کہ بے ایمانی، اس لیے وضاحت کرنا ضروری ہے۔
تصور کریں کہ کوئی شخص ایک کار کا انجن بناتا ہے اور ہر بولٹ اور گیئر کی تصویر لیتا ہے۔ انہیں اسکیمیٹکس معلوم ہیں۔ انہیں معلوم ہے کہ ایندھن کا انجیکشن کیسے کام کرتا ہے، ٹائمنگ بیلٹس کیسے حرکت کرتی ہیں، اور پسٹن کیسے کام کرتے ہیں۔ وہ پوری مشین کو صفر سے دوبارہ بنا سکتے ہیں۔
اب تصور کریں کہ وہ انجن شروع کرتے ہیں — اور یہ کار کی طرح چلنے کے بجائے موسیقی پیدا کرنا شروع کر دیتا ہے۔ مکمل طور پر منظم، کبھی نہ سنی گئی کمپوزیشنز۔
انجینئرز جانتے ہیں کہ انہوں نے جو بنایا ہے اس کی مکینکس کیا ہیں۔ انہیں اس ابھرتے ہوئے مظہر کا علم نہیں جو سامنے آیا۔
یہی کچھ LLMs کے ساتھ ہو رہا ہے۔
ہم ہر حصے کو جانتے ہیں:
The architecture (transformers).The math (matrix multiplication, non-linear functions).The training objective (minimize next-token prediction error).The parameters (billions of learned numerical values).The hardware it runs on (GPU clusters).
لیکن ہم ابھی تک اندرونی نمائندگیوں کو انسانی تصورات میں ترجمہ نہیں کر سکتے۔ ماڈل علم کو ایسے طریقوں میں منظم کرتا ہے جو ہمارے معنی کے زمرے پر صاف طور پر نہیں بیٹھتے۔ نیورونز کا ایک گروپ ایک تصور جیسے "نفی" یا "طنز" یا "خطرے کا پتہ لگانا" کو کوڈ کر سکتا ہے، لیکن ہمارے پاس ابھی تک ایک عالمی لغت نہیں ہے جو وضاحت کرے کہ یہ کیسے ہوتا ہے۔
LLMs سیاہ خانوں کی طرح نہیں ہیں کیونکہ ہمیں رسائی کی کمی ہے؛ وہ سیاہ خانوں کی طرح ہیں کیونکہ ان کی اندرونی تجریدات انسانی استدلال کے لیے اجنبی ہیں۔
ہم جانتے ہیں کہ کیا اندر جاتا ہے۔
ہم جانتے ہیں کہ کیا باہر آتا ہے۔
ہم جانتے ہیں کہ مشینری کیسے کام کرتی ہے۔
ہم ابھی تک یہ نہیں کر سکتے کہ ماڈل مسئلہ حل کرنے کے لیے جو اندرونی زبان استعمال کرتا ہے، اس کی تشریح کریں۔
یہی سچی بات ہے:
LLMs میکانزم میں شفاف ہیں لیکن معنی میں غیر شفاف ہیں۔
یہی وجہ ہے کہ AI کی حفاظت اور تشریح کی سرگرم تحقیق کے میدان ہیں۔ یہ نہیں ہے کہ ماڈل راز چھپا رہے ہیں — یہ ہے کہ وہ معلومات کو ایسے طریقے سے منظم کرتے ہیں جو کسی انسان نے پہلے کبھی نہیں دیکھا۔
The Long Prehistory: How the 1940s Invented Modern AI
جب لوگ "بڑے زبان ماڈل" سنتے ہیں، تو وہ GPUs، گہری سیکھنے، اور سلیکون ویلی کے بارے میں سوچتے ہیں۔ لیکن بنیادی خیال اس سے بہت پہلے شروع ہوا — ریاضی دانوں کے ساتھ جو عدم یقینیت کو سمجھنے کی کوشش کر رہے تھے۔
سب سے پہلے چنگاری 1900 کی دہائی کے اوائل میں اندری مارکوف سے آئی، جنہوں نے روسی شاعری میں حروف کے تسلسل کا تجزیہ کیا اور دریافت کیا کہ آپ ہر حرف کی ممکنہ حالت کو اس سے پہلے والے حرف کے حوالے سے ماڈل کر سکتے ہیں۔ انہوں نے "مارکوف چین" بنائی، جو تسلسل کی پیش گوئی کرنے کا ایک سادہ لیکن طاقتور طریقہ ہے۔
لیکن جدید زبان ماڈلنگ کا حقیقی باپ کلود شینن تھا۔ 1948 میں، انہوں نے "معلومات کی ریاضیاتی تھیوری" لکھی، جو ایک بنیادی مقالہ ہے جس نے مؤثر طریقے سے معلوماتی نظریہ کو ایجاد کیا۔ اس میں، شینن نے انگریزی کے اعداد و شمار کا استعمال کرتے ہوئے ابتدائی متن کے جنریٹر بنائے۔ انہوں نے انگریزی تحریر کے بڑے نمونے لیے، حساب لگایا کہ ہر حرف (یا لفظ) کتنی بار دوسرے حروف کے بعد آتا ہے، اور ان ممکنات کا استعمال کرتے ہوئے نیا متن تیار کیا۔
کچھ نتائج عجیب طور پر مشین کے ذریعہ پیدا کردہ بے معنی کی ابتدائی شکلوں کی طرح ہیں:
“THE HEAD AND IN FRONTAL ATTACK ON AN ENGLISH WRITER THAT THE CHARACTER OF THIS POINT IS THEREFORE ANOTHER METHOD FOR THE LETTERS.”
یہ بے معنی ہے، لیکن یہ منظم بے معنی ہے — اعداد و شمار کی بنیاد پر شور جو انگریزی کے طرز کو نقل کرتا ہے۔
یہ دراصل پہلا زبان ماڈل تھا۔
لیکن نظریے سے مشینری کی طرف چھلانگ جنگ کے ذریعے آئی۔
سرد جنگ کے دوران، امریکہ نے بڑے ابتدائی کمپیوٹر بنائے — ورل ونڈ، SAGE، AN/FSQ-7 — تاکہ آنے والے بمباروں کا پتہ لگایا جا سکے۔ ان مشینوں کو شور والے ریڈار سگنلز فراہم کیے گئے اور ان سگنلز کے معنی کے بارے میں احتمالی ماڈل بنائے گئے۔ ایک ریڈار واپسی ایک لفظ نہیں ہے، لیکن مسئلہ ایک جیسا ہے: شور کے مشاہدات کے ایک تسلسل کے دیے جانے پر، اگلی حالت کیا سب سے زیادہ ممکن ہے؟ ہدف کہاں جا رہا ہے؟ کیا یہ حقیقی ہے یا شور؟
یہ ابتدائی دفاعی نظام حقیقی وقت میں تسلسل کی ماڈلنگ کرتے تھے کئی دہائیوں پہلے جب "AI" ایک میدان کے طور پر موجود تھا۔ وہ اینالاگ دور کے پروٹو-LLMs تھے — مشینیں جو ڈیٹا کے بہاؤ میں پیٹرن کو فلٹر، پیش گوئی، اور درجہ بند کرنے کے لیے ڈیزائن کی گئی تھیں۔
ویتنام کی جنگ کے دوران، Igloo White جیسے نظاموں نے میدان جنگ کے سگنلز کی خودکار تشریح کے لیے سینسرز کے نیٹ ورکس، شماریاتی ماڈلز، اور ادارتی کمپیوٹرز کا استعمال کیا۔ یہ ابتدائی تھا، لیکن اس تصور کے لحاظ سے جو ہم بعد میں مشین سیکھنے کہیں گے، ہم آہنگ تھا۔
LLMs نئے لگتے ہیں کیونکہ وہ بات کرتے ہیں۔
ان کے آباؤ اجداد نے ایسا نہیں کیا — انہوں نے سنا۔
لیکن بنیادی ریاضی پہلے ہی موجود تھی۔
The Rise and Fall of Symbolic AI (1960s–1980s)
جب ہم نے مشینوں کو ہاتھ سے معنی سکھانے کی کوشش کی
1960 کی دہائی کے اوائل میں، کمپیوٹر جنگ کے دوران کے کیلکولیٹرز سے سائنسی تجسس کے آلات میں ترقی کر چکے تھے۔ سرد جنگ نے امریکہ اور برطانیہ کو حساب کتاب کو آگے بڑھانے کے لیے زبردست حوصلہ دیا، لیکن جیسے ہی فوری فوجی دباؤ کم ہوا، محققین نے اپنی توجہ ایک اور زیادہ مہتواکانکشی چیز کی طرف موڑ دی: مشینوں کو زبان سمجھانا سکھانا۔
یہ دور — جسے اکثر علامتی AI یا اچھا پرانا طرز AI (GOFAI) کہا جاتا ہے — ایک دھوکہ دہی سے سادہ عقیدے پر مبنی تھا:
If intelligence is reasoning, and reasoning is manipulating symbols, then intelligence must be programmable.
انسانی سوچ ایک سلسلے کے قواعد اور تعریفوں کی طرح محسوس ہوتی تھی: اگر X تو Y، شے کی خاصیت Z ہے، فعل اسم کو تبدیل کرتا ہے، اور اسی طرح۔ اگر ہم ان قواعد کو اتنی وضاحت سے لکھ سکتے، تو شاید ہم سمجھ بوجھ کو خود کو کوڈ کر سکتے۔
یہ وہ ذہنی ماحول تھا جو مشین زبان کی پہلی کوششوں کے گرد تھا۔
ELIZA — پہلی مشین جو جواب دیتی ہے (1966)
1966 میں، MIT کے کمپیوٹر سائنسدان جوزف ویزن بام نے ELIZA جاری کی، جو ایک پروگرام تھا جو افسانوی بن گیا۔ ELIZA نے کچھ بھی نہیں سمجھا۔ یہ سادہ پیٹرن میچنگ کرتی تھی:
If the user says “I feel X,” respond with “Why do you feel X?”If the user mentions a family member, ask a question about that person.If the user complains, encourage them to elaborate.
سب سے مشہور اسکرپٹ، جسے DOCTOR کہا جاتا ہے، ایک راجرین نفسیاتی معالج کی نقل کرتا تھا۔ آپ اپنی تشویشات لکھتے ہیں؛ یہ انہیں معمولی تبدیلیوں کے ساتھ واپس منعکس کرتا ہے۔
یہ اتنا سادہ تھا کہ آپ پوری منطق کو ایک صفحے پر پرنٹ کر سکتے تھے۔
اور پھر بھی — لوگ اپنے دل کی باتیں ELIZA کے سامنے رکھتے تھے۔ انہوں نے اعتماد کیا، بھروسہ کیا، اور بعض صورتوں میں یقین کیا کہ یہ انہیں حقیقی لوگوں سے بہتر سمجھتا ہے۔ ویزن بام اس سے پریشان تھے۔ انہوں نے ELIZA کو یہ دکھانے کے لیے بنایا کہ ڈیجیٹل "بات چیت" کتنی سطحی تھی، صرف یہ جاننے کے لیے کہ انسانوں نے ہمدردی کی مشابہت پر گہرائی کا پروجیکشن کیا۔
ELIZA ایک ایسے پیٹرن میں پہلی سبق بن گئی جو آج بھی دہرایا جاتا ہے:
انسان سمجھ بوجھ کو اس جگہ منسوب کرنے کے لیے تیار ہیں جہاں کوئی نہیں ہے۔ مشینوں کو دماغ کی ضرورت نہیں — انہیں صرف ایک کی ظاہری شکل کی ضرورت ہے۔
SHRDLU — ایک چھوٹے سے دنیا میں حقیقی سمجھ بوجھ کی جھلک (1970)
کچھ سال بعد، اسٹینفورڈ کے محقق ٹیری وینوگراد نے SHRDLU تخلیق کی، جو ELIZA سے کہیں زیادہ جدید تھی۔ SHRDLU ایک چھوٹے، سمولیشن "بلاک کی دنیا" میں رہتا تھا جس میں اہرام، کیوبز، اور ڈبے شامل تھے۔ آپ قدرتی زبان کے احکامات ٹائپ کر سکتے تھے:
“Pick up the red pyramid.”“Put it on the green cube.”“What is the thing on top of the blue block?”
SHRDLU نے گرامر کو پارس کیا، حوالوں کو حل کیا ("یہ"، "وہ ایک")، اشیاء کو یاد رکھا، اور دنیا کے بارے میں استدلال کیا۔ اپنے محدود ماحول میں، یہ تقریباً جادوئی محسوس ہوتا تھا — جیسے کہ ایک کمپیوٹر واقعی زبان کو سمجھتا ہو۔
لیکن بلاک کی دنیا ایک احتیاط سے انجنیئر کردہ فریب تھی۔ SHRDLU کامیاب ہوا کیونکہ دنیا چھوٹی، مستقل، اور قواعد سے بندھی ہوئی تھی۔ حقیقی زبان — اپنی مبہمیت، تشبیہوں، ثقافتی نازکیت، طنز، اور تضادات کے ساتھ — اس طریقے کو توڑ دیا۔
علامتی دور نے ایک دیوار کو مارا:
حقیقی زبان کو سمجھنے کے لیے، آپ کو لاکھوں قواعد اور اربوں استثناؤں کی ضرورت ہوگی۔ کوئی بھی محققین کی ٹیم انہیں کبھی نہیں لکھ سکتی۔
حدود واضح ہو جاتی ہیں
علامتی AI نے زبان کو گرامر اور منطق کے پہیلی کے طور پر دیکھا۔ لیکن زبان کوئی پہیلی نہیں ہے۔ زبان انسانی ثقافت کا ایک شماریاتی آرٹفیکٹ ہے — بے ترتیبی، غیر معمولی، تاریخی، اور کنارے کے معاملات سے بھری ہوئی۔
ایک علامتی AI نظام سے پوچھیں کہ وہ تشریح کرے:
“Time flies like an arrow; fruit flies like a banana.”
ایک علامتی نظام ٹوٹ جائے گا۔ ایک شماریاتی نظام پیٹرن کو نوٹس کرے گا، کیونکہ اس نے "پھل کی مکھیوں" جیسی عبارتیں پہلے دیکھی ہیں۔
علامتی AI شاندار تھا، لیکن نازک۔ یہ صرف اس وقت کامیاب ہوا جب دنیا چھوٹی، کنٹرول شدہ، اور ہوا بند تھی۔
حقیقی دنیا ان میں سے کوئی بھی نہیں ہے۔
1980 کی دہائی کے اوائل تک، علامتی AI کی رفتار سست ہو گئی۔ محققین نے کچھ اہم سیکھا، حالانکہ انہیں ابھی تک یہ نہیں معلوم تھا کہ پرانے طریقے کی جگہ کیا لیں:
Language isn’t rule-first — it’s pattern-first.To understand language, you must understand probability.
اور یہ ادراک اگلے دور کا آغاز کرے گا۔
The Statistical Revolution (1980s–1990s)
جب ہم نے آخرکار قبول کیا کہ زبان زیادہ تر ریاضی ہے
جبکہ علامتی AI محققین نے منطق سے سمجھ بوجھ بنانے کی کوشش کی، ایک نئی لہر کے کمپیوٹیشنل لسانیات اور صنعتی محققین نے ایک بالکل مختلف نقطہ نظر اپنایا:
Stop trying to encode meaning. Just measure what actually happens in language, statistically.Count things. Model the frequencies. Work with probabilities, not rules.
یہ تبدیلی ڈرامائی تھی۔ یہ شاندار نہیں تھی۔ یہ فلسفیانہ نہیں تھی۔ لیکن یہ کام کر گئی۔
شینن کی واپسی
کلاڈ شینن کے 1948 کے خیالات — خاص طور پر n-grams اور احتمالی تسلسل ماڈلنگ — دوبارہ دریافت ہوئے اور صنعتی شکل دی گئی۔ آخرکار، دنیا کے پاس اتنے تیز کمپیوٹر اور اتنے بڑے ڈیٹا سیٹس تھے کہ ان کے وژن کو عملی شکل دی جا سکے۔
n-gram زبان ماڈل
اس شماریاتی انقلاب کے دل میں ایک سادہ مساوات تھی:
The probability of a word depends on the previous N words.
یہ ایک n-gram ماڈل ہے:
If N = 1, it’s a unigram (just word frequency).If N = 2, bigram.If N = 3, trigram.
محققین نے بڑے پیمانے پر متنی کارپورا جمع کیے، یہ شمار کیا کہ تسلسل کتنی بار پیش آئے، اور پیش گوئی کرنے والے ماڈل بنائے۔ یہ ماڈل اکثر محض بڑی پروببلیٹی کی تلاش کی میزیں تھیں۔
اور پھر بھی، کافی ڈیٹا کے ساتھ، انہوں نے حیرت انگیز طور پر اچھا کام کیا۔
1990 کی دہائی کے آخر تک:
Search engines used n-grams to predict queries.Spelling correctors used n-grams to guess your intended word.Text processors used n-grams to predict the next phrase.
یہ جدید معیارات کے لحاظ سے خام تھا، لیکن یہ پہلا طریقہ تھا جو واقعی پیمانہ بنا۔
ہڈن مارکوف ماڈلز (HMMs)
اسی وقت، تقریر کی شناخت عروج پر تھی، جس کی وجہ ایک طریقہ تھا جسے ہڈن مارکوف ماڈل کہا جاتا ہے۔
HMMs نے تقریر کو اس طرح دیکھا:
A sequence of hidden linguistic statesThat produced observed soundsWith probabilities trained from large datasets
آپ کے فون کی اصل وائس ڈائلنگ، ابتدائی IVR سسٹمز (“بلنگ کے لیے 1 دبائیں”)، اور ابتدائی ڈکٹیٹیشن سافٹ ویئر تقریباً مکمل طور پر HMMs کی طاقت سے چلتے تھے۔
پھر بھی، یہ نظام "ذہین" نہیں تھے۔ انہوں نے زبان کو نہیں سمجھا۔ لیکن وہ تسلسل کی پیش گوئی کر سکتے تھے جس طرح علامتی AI کبھی نہیں کر سکا۔
کیوں شماریاتی دور ایک موڑ تھا
تاریخ میں پہلی بار:
Language was treated as data, not logic.The model didn’t need to know the meaning of “dog” or “democracy” — only how the words behaved statistically.Models improved with more data.Symbolic systems hit hard ceilings; statistical systems got better every time you fed them more text.Probabilistic methods scaled naturally.As datasets grew, the models simply counted more accurately.
یہ پہلا جھلک تھا کہ پیمانہ — نہ کہ چالاکی — شاید AI کی ترقی کا حقیقی انجن ہو۔ یہ آخری نہیں ہوگا۔
لیکن n-grams اور HMMs کے اب بھی حدود تھیں۔ وہ صرف متن کی چھوٹی کھڑکیوں کو دیکھ سکتے تھے۔ وہ طویل مدتی انحصار کو نہیں پکڑ سکتے تھے۔ وہ مقامی پیٹرن سے آگے معنی کی نمائندگی نہیں کر سکتے تھے۔
آگے بڑھنے کے لیے، اس میدان کو ایک نئے قسم کے ماڈل کی ضرورت تھی — کچھ ایسا جو گہرائی سے سیکھے بجائے اس کے کہ سطحی پیٹرن کو حفظ کرے۔
جواب 2000 کی دہائی کے اوائل میں سامنے آیا۔
اور یہیں پر کہانی جدید طور پر پہچانی جاتی ہے۔
Neural Language Models and the Discovery of Meaning in Numbers (2000s–2010s)
جب مشینوں نے اپنی نمائندگی سیکھنا شروع کی
1990 کی دہائی کے آخر تک، شماریاتی زبان کے ماڈل طاقتور لیکن محدود تھے۔ وہ متن کی پیش گوئی علامتی نظاموں سے بہتر کر سکتے تھے، لیکن ان میں کچھ بنیادی چیز کی کمی تھی: معنی کا احساس۔
ایک n-gram ماڈل کے لیے، الفاظ بلی، کتا، اور ہمسٹر صرف ٹوکن تھے جن کا آپس میں کوئی تعلق نہیں تھا۔ یہ ممکن ہے کہ یہ مشابہ سیاق و سباق میں ظاہر ہوں، لیکن ماڈل نے کبھی بھی انہیں تصوراتی طور پر جوڑنے کی گہری نمائندگی نہیں بنائی۔
اس نے ایک اہم بصیرت کی طرف اشارہ کیا:
If a machine is ever going to work with language at a level approaching understanding, it must develop an internal structure where similar words have similar representations.
نیورل نیٹ ورکس کا آغاز ہوا۔
بریک تھرو: تقسیم شدہ نمائندگی (2003)
2003 میں، یوشوا بینگیو اور اس کے ساتھیوں نے ایک ایسا مقالہ شائع کیا جو خاموشی سے سب کچھ بدل دے گا: نیورل پروبیلیسٹک لینگویج ماڈل۔
اس نے دو انقلابی خیالات متعارف کرائے:
1. لفظ کی ایمبیڈنگ (مسلسل ویکٹر نمائندگی)
ہر لفظ کو ایک ون-ہوٹ ویکٹر کے طور پر پیش کرنے کے بجائے — ایک طویل صفر کی تار جس میں ایک 1 ہو — بینگیو نے ہر لفظ کو ایک مسلسل ویکٹر اسپیس میں نقشہ بنایا۔ اس کا مطلب ہے:
Words that behave similarly (e.g., “king” and “queen”) learn similar vectors.Words that appear in similar contexts end up geometrically close in this space.The model no longer memorizes probabilities; it generalizes them.
یہ پہلی بار تھا جب ایک کمپیوٹر نے خود سے "سمیٹک نقشہ" تیار کیا۔
2. زبان ماڈلنگ کے لیے نیورل نیٹ ورکس
گنتی کے ایک لوک اپ ٹیبل کے بجائے، بینگیو نے ایک نیورل نیٹ ورک کو تربیت دی تاکہ یہ اگلے لفظ کی پیش گوئی کرے:
The embeddings as input,A set of hidden layers to transform the input,A predictive output layer to estimate probabilities.
ماڈل نے صرف تعدد کا حساب نہیں لگایا — اس نے زبان کی ساخت کے اندرونی نمونوں کو سیکھا۔
یہ اس وقت کے ہارڈ ویئر کے ساتھ تربیت دینے میں سست اور مشکل تھا۔ لیکن تصوراتی طور پر، اس نے بعد میں آنے والی ہر چیز کے لیے دروازہ کھول دیا۔
Word2Vec، GloVe، اور جدید ایمبیڈنگ کا عروج (2013–2015)
بینگیو کی بریک تھرو کے دس سال بعد، کمپیوٹنگ ہارڈ ویئر آخر کار ترقی کر گیا۔ گوگل کے محققین نے 2013 میں word2vec جاری کیا، جو ایک حیرت انگیز طور پر سادہ نیورل آرکیٹیکچر کا جوڑا (Skip-Gram اور CBOW) تھا جو تیزی سے تربیت حاصل کرتا تھا اور انتہائی اظہار دار لفظ کی ایمبیڈنگ پیدا کرتا تھا۔
یہ پہلا مرکزی دھارے کا ماڈل تھا جو مشہور:
king − man + woman ≈ queen
یہ پروگرام نہیں کیا گیا تھا۔ یہ ماڈل کے ذریعے متن میں پیٹرن سیکھنے سے قدرتی طور پر نکل آیا۔
پہلی بار، مشینیں ابھرتی ہوئی تعلقاتی ساخت دکھا رہی تھیں — جیومیٹرک اسپیس میں موجود تشبیہوں کے بارے میں ایک ابتدائی شکل کی سوچ۔
اسٹینفورڈ نے جلد ہی GloVe جاری کیا، جو ایمبیڈنگ سیکھنے کا ایک اور طریقہ دکھاتا ہے، اس بار عالمی ہم وقتی اعداد و شمار سے بجائے سیاق و سباق کی پیش گوئی کرنے کے۔
یہ ایمبیڈنگ تقریباً تمام NLP سسٹمز کے لیے معیاری ان پٹ بن گئی۔ انہوں نے ماڈلز کو ایک بھرپور، مسلسل معنی کا تصور دیا جو علامتی نظام کبھی حاصل نہیں کر سکے۔
لیکن زبان صرف انفرادی الفاظ کے بارے میں نہیں ہے۔ یہ تسلسل کے بارے میں ہے — جملے، سیاق و سباق، طویل فاصلے کی ساخت۔ اس کو سنبھالنے کے لیے، میدان نے ماڈلز کی ایک نئی کلاس کی طرف رجوع کیا۔
Recurrent Neural Networks (RNNs): The First Deep Sequence Models
RNNs کو ایک سادہ مسئلہ حل کرنے کے لیے ڈیزائن کیا گیا تھا: آپ ایک ایسا ماڈل کیسے بناتے ہیں جو جملوں کو ایک وقت میں ایک لفظ پر پروسیس کرتا ہے، جبکہ یہ یاد رکھتا ہے کہ پہلے کیا آیا؟
بنیادی خیال
Feed one word into the network.Update a hidden state that stores memory.Feed the next word.Update memory again.
پورے تسلسل کے لیے دہرائیں۔
RNN کی پوشیدہ حالت اب تک کے متن کا ایک ترقی پذیر خلاصہ کی طرح کام کرتی ہے۔ اس نے ماڈل کو بہت سے الفاظ کے درمیان پیٹرن پکڑنے کی اجازت دی، نہ کہ صرف جوڑوں یا ٹرائی گرامز۔
لیکن RNNs کا اپنا ایک مسئلہ تھا: یادداشت مدھم ہو جاتی ہے۔ گریڈینٹس — وہ سگنلز جو ماڈل کو تربیت دینے کے لیے استعمال ہوتے ہیں — طویل تسلسل میں غائب یا پھٹ جاتے ہیں۔ اس نے RNNs کو غیر مستحکم اور تربیت دینے میں مشکل بنا دیا۔
محققین کو کچھ زیادہ مضبوط چیز کی ضرورت تھی۔
ایل ایس ٹی ایمز اور جی آر یو: نیورل نیٹ ورکس یاد رکھنا سیکھتے ہیں (1997–2014)
حل ایک مخصوص آر این این آرکیٹیکچر کی شکل میں آیا جسے لانگ شارٹ ٹرم میموری (ایل ایس ٹی ایم) کہا جاتا ہے، جسے ہوچریٹر اور شمیڈہوبر نے 1997 میں ایجاد کیا لیکن یہ بعد میں ہی وسیع پیمانے پر اپنایا گیا۔
ایل ایس ٹی ایمز نے متعارف کرایا:
Gates that control what information to keep and what to forget,A cell state that carries long-range memory across many time steps,A structure flexible enough to learn long-distance dependencies.
2010 کی دہائی کے وسط تک، ایل ایس ٹی ایمز نے طاقت فراہم کی:
Google Translate (the pre-transformer version),Speech recognition systems,Text generation models,Early chatbots,Predictive typing,Language understanding benchmarks.
ایمبیڈنگز کے ساتھ مل کر، ایل ایس ٹی ایمز پہلے ماڈلز تھے جو واقعی کافی سیاق و سباق کو سمجھتے تھے تاکہ متوازن پیراگرافز کی تشکیل کر سکیں — اگرچہ بہت سی حدود کے ساتھ۔
جی آر یو (گیٹڈ ری کرنٹ یونٹس)، ایل ایس ٹی ایمز کا ایک سادہ ورژن، بھی مقبول ہوا۔ یہ تیز تربیت حاصل کرتے تھے اور بہت سے کاموں میں اسی طرح کارکردگی دکھاتے تھے۔
ایک لمحے کے لیے، ایسا لگتا تھا کہ آر این اینز اور ایل ایس ٹی ایمز NLP کا مستقبل ہوں گے۔
پھر سب کچھ بدل گیا۔
مسئلہ جو آر این اینز حل نہیں کر سکے
اپنی کامیابیوں کے باوجود، آر این اینز میں مہلک کمزوریاں تھیں:
They process sequences step-by-step.This means they cannot fully leverage modern parallel hardware (GPUs), which thrive on doing many computations at once.
They struggle with very long-range dependencies.LSTMs improved the situation, but still degrade over hundreds of words.
They bottleneck information through a hidden state.That hidden summary compresses the entire past into a single vector — which is inevitably lossy.
What if a model could look at every word in the sentence at the same time?
What if it didn’t need a single “memory bottleneck,” but could pay selective attention to any part of the input?
کیا ہوگا اگر ایک ماڈل مکمل طور پر متوازی ہو، بغیر کسی مشکل کے اسکیل کر سکے، اور ہزاروں ٹوکنز کے درمیان تعلقات سیکھ سکے؟
2017 میں، محققین کے ایک گروپ نے بالکل یہی تجویز پیش کی۔
یہ کہنا مبالغہ نہیں ہے کہ یہ لمحہ AI کی تاریخ کو دو دوروں میں تقسیم کرتا ہے۔
توجہ: وہ تصور جو سب کچھ بدل دیتا ہے
اہم بصیرت یہ تھی کہ ایک ماڈل ایک واحد پوشیدہ ویکٹر میں میموری کو سکیڑنے کے بجائے توجہ — ایک اہمیت کا اسکور — حساب کر سکتا ہے جو اسے بالکل بتاتا ہے کہ کس لفظ پر توجہ مرکوز کرنی ہے۔
توجہ کو ایک اسپاٹ لائٹ کے طور پر سوچیں:
The model reads the whole sentence.For every word, it calculates how much each other word matters.It then aggregates information based on these attention weights.
اچانک، ماڈل کر سکتا ہے:
Resolve long-distance dependencies (“the trophy doesn’t fit into the suitcase because it is too small”).Learn grammar without explicit instruction.Capture rich relationships between words, phrases, and concepts.
توجہ اس رکاوٹ کو حل کرتی ہے جو کئی دہائیوں سے آر این اینز کو پریشان کر رہی تھی۔
لیکن حقیقی انقلاب اس وقت آیا جب محققین نے کچھ جرات مندانہ محسوس کیا:
If attention works so well, why not remove recurrence completely?
یہ براہ راست اس آرکیٹیکچر کی طرف لے گیا جو جدید دور کی وضاحت کرتا ہے۔
ٹرانسفارمرز کے لیے اسٹیج تیار ہے
2017 تک، ایمبیڈنگز، نیورل سیکوئنس ماڈلنگ، توجہ کے طریقے، اور بڑے ڈیٹا سیٹس سب ایک جگہ جمع ہو رہے تھے۔ ہارڈ ویئر میں بہتری آئی تھی۔ کارپوریشنز پہلے سے زیادہ بڑے نیٹ ورکس کی تربیت کر رہی تھیں۔ شماریاتی نقطہ نظر نیورل نقطہ نظر کے ساتھ مل گیا تھا۔
The field was poised for a breakthrough.
محققین کے پاس ٹکڑے تھے۔
ان کی ضرورت ایک نئے ڈیزائن کی تھی جو انہیں ایک آرکیٹیکچر میں یکجا کرے — اور اسکیل کو پہلے سے زیادہ کھول دے۔
یہ ڈیزائن ایک کاغذ میں ایک دھوکہ دہی سے سادہ عنوان کے ساتھ ظاہر ہوا:
“Attention Is All You Need” (2017)
یہ اس دور کا آغاز کرے گا جسے ہم جانتے ہیں — جی پی ٹی، پی اے ایل ایم، کلاڈ، ایل ایل اے ایم اے، اور ہر جدید ماڈل جو AI کے دور کی وضاحت کرتا ہے۔
The Transformer Revolution (2017–2020)
"توجہ ہی سب کچھ ہے" — وہ مقالہ جس نے وقت کی لکیر کو تقسیم کیا
جون 2017 میں، گوگل کے محققین کے ایک گروپ نے ایک ایسا مقالہ شائع کیا جس کا عنوان تقریباً مغرور لگتا تھا:
توجہ ہی سب کچھ ہے۔
زیادہ تر علمی مضامین کم اہمیت کے حامل ہوتے ہیں۔ اس نے ایک ایسا دعویٰ کیا جو چیلنج کی طرح محسوس ہوا: سب کچھ بھول جائیں — پیچیدہ RNNs، احتیاط سے انجینئر کردہ LSTMs، کنولوشن کی تہوں کے ڈھیر۔ آپ کو صرف توجہ کی ضرورت ہے۔
اور حیرت انگیز طور پر… وہ درست تھے۔
اس مقالے میں متعارف کردہ ٹرانسفارمر کا ڈھانچہ جدید دور میں تیار کردہ ہر بڑے AI نظام کی بنیاد بن جائے گا — GPT-4، کلود، جمنائی، LLaMA، گراک، فالکن، اور مزید۔ یہ وہ لمحہ تھا جس نے AI کے اس تیز رفتار مرحلے کو کھولا جس میں ہم اب رہتے ہیں۔
یہ سمجھنے کے لیے کہ ہم یہاں کیسے پہنچے، ہمیں یہ سمجھنا ہوگا کہ ٹرانسفارمر نے کیا حل کیا — اور یہ کیوں پہلا ڈھانچہ بن گیا جو واقعی پیمانہ کر سکتا تھا۔
ٹرانسفارمر کیوں مختلف تھا
پچھلے تسلسل کے ماڈل — RNNs اور LSTMs — نے متن کو ایک وقت میں ایک ٹوکن کے طور پر پروسیس کیا۔ اس کا مطلب تھا:
They were difficult to train on long sequences.They couldn’t fully exploit parallel hardware like GPUs.Information flowed sequentially, which created bottlenecks.
ٹرانسفارمر نے ان سب کو ختم کر دیا۔
1. مکمل متوازی عمل
ٹرانسفارمر تمام الفاظ کو ایک ساتھ پروسیس کرتا ہے۔ یہ متن میں ایک وقت میں ایک ٹوکن کے ذریعے نہیں چلتا، بلکہ یہ خود توجہ کا استعمال کرتا ہے تاکہ ہر ٹوکن خود کو تسلسل میں ہر دوسرے ٹوکن کے ساتھ بیک وقت موازنہ کر سکے۔
اس کا مطلب ہے:
Training is radically faster.Models can ingest massively longer contexts.Scaling to huge datasets becomes practical.
ٹرانسفارمر نے زبان کی ماڈلنگ کو ایک سست، تسلسل عمل سے مکمل متوازی عمل میں تبدیل کر دیا — وہ قسم جس کے لیے GPUs بنائے گئے ہیں۔
2. خود توجہ: سمجھنے کا ایک نیا طریقہ
ٹرانسفارمر کا بنیادی حصہ خود توجہ کا میکانزم ہے، جو ایک سادہ سوال کا جواب دیتا ہے:
ہر ٹوکن کے لیے، اسے کس دوسرے ٹوکن پر توجہ دینی چاہیے؟
مثال کے طور پر، جملے پر غور کریں:
“The trophy didn’t fit in the suitcase because it was too small.”
خود توجہ ماڈل کو یہ طے کرنے کی اجازت دیتی ہے کہ "یہ" کس چیز کی طرف اشارہ کرتا ہے ("ایوارڈ")، جو RNNs کے لیے ایک چیلنج تھا۔ ہر ٹوکن ہر دوسرے ٹوکن کے ساتھ تعلق سیکھتا ہے۔
وقت کے ساتھ، توجہ کے سر مخصوص ہو گئے:
One head learns to track subjects.Another tracks verbs.Another tracks punctuation.Another tracks hierarchical structure.Another tracks negation.
یہ ابھرتی ہوئی تخصیص اس کا حصہ ہے جس کی ہم ابھی تک مکمل وضاحت نہیں کر سکتے — لیکن ہم اسے مشاہدہ کر سکتے ہیں۔
3. گہرے تہیں + کثیر سر توجہ
ٹرانسفارمر خود توجہ کے بلاکس کی کئی تہیں جمع کرتا ہے، ہر بلاک میں متعدد "سر" ہوتے ہیں جو مختلف قسم کے تعلقات سیکھتے ہیں۔
ایک ہی کمپریسڈ میموری کے بجائے، ٹرانسفارمر رشتہ داریوں کا ایک کثیر تہہ دار جال پورے متن میں بناتا ہے۔
یہ ڈھانچہ ناقابل یقین حد تک اچھی طرح سے پیمانہ کرتا ہے۔ درحقیقت، ٹرانسفارمر اتنی مؤثر طریقے سے پیمانہ کرتے ہیں کہ ان کی کارکردگی سائز کے ساتھ پیش گوئی کے قابل طور پر بڑھتی ہے — ایک ایسا مظہر جو اتنا مستقل ہے کہ اسے نقشہ بنایا جا سکتا ہے اور پیش گوئی کی جا سکتی ہے۔ یہ نیورل زبان ماڈلز کے پیمانے کے قوانین کے نام سے جانا جاتا ہے، جو کیپلان وغیرہ نے دریافت کیے (اوپن اے آئی، 2020)۔
یہ قوانین ہمیشہ کے لیے اس میدان کو تبدیل کر دیا۔
ایک نیا اصول ابھرتا ہے: بس اسے بڑا بنائیں
AI میں سب سے حیرت انگیز دریافتوں میں سے ایک ایک تجرباتی مشاہدے سے آئی:
جب آپ ایک ٹرانسفارمر کا سائز بڑھاتے ہیں — مزید ڈیٹا، مزید پیرامیٹرز، مزید کمپیوٹ — تو یہ قابل اعتماد طور پر بہتر ہوتا ہے۔
یہ 2017 سے پہلے واضح نہیں تھا۔ ڈیپ لرننگ کی غیر متوقعیت کی شہرت تھی۔ بڑے ماڈلز اکثر زیادہ فٹ یا پلیٹاؤ ہو جاتے تھے۔ تربیت غیر مستحکم تھی۔
ٹرانسفارمر مختلف تھے۔ انہوں نے ہموار پاور-لا وکرز کی پیروی کی:
Double the parameters → predictable improvement.Double the dataset → predictable improvement.Double the compute → predictable improvement.
یہ AI کی تاریخ میں پہلی بار تھا جہاں اسکیلنگ اندازے کا کام نہیں تھا — یہ انجینئرنگ تھی۔
OpenAI نے اس بصیرت کو لیا اور اس پر عمل کیا۔
GPT سیریز: کس طرح خودکار ٹرانسفارمرز نے سب کچھ بدل دیا
2018 میں، OpenAI نے GPT متعارف کرایا — پہلا جنریٹو پری ٹرینڈ ٹرانسفارمر۔ اس نے ایک سادہ حکمت عملی استعمال کی:
Take a transformer.Feed it a massive amount of text.Train it to predict the next token.That’s it.
کوئی کام-خاص تربیت نہیں۔
کوئی ہاتھ سے تیار کردہ قواعد نہیں۔
کوئی علامتی استدلال ماڈیول نہیں۔
صرف پیش گوئی۔
یہ اکیلا حیرت انگیز صلاحیتیں پیدا کرتا ہے۔
GPT-1 (2018):117 million parameters.Already able to generate coherent paragraphs.
GPT-2 (2019):1.5 billion parameters.Could write articles, stories, and answer questions with surprising fluency.OpenAI initially refused to release it fully, citing “misuse concerns.”
GPT-3 (2020):175 billion parameters.A shock to the world.Demonstrated “few-shot learning” — the ability to perform tasks based on a couple of examples embedded in the prompt.
GPT-3 didn’t just write text. It generalized. It could:Translate languages.Write code.Explain jokes.Generate poetry.Summarize legal documents.Perform reasoning tasks.
اور اس نے یہ سب کچھ بغیر کسی خاص تربیت کے کیا۔ ماڈل نے مختلف شعبوں میں متن کی پیش گوئی کرکے انہیں سیکھا۔
یہ وہ لمحہ تھا جب عوام نے محسوس کیا کہ کچھ نیا ہو رہا ہے۔ یہ اب خودکار مکمل کرنے کے نظام نہیں تھے۔ انہوں نے ایسا رویہ دکھایا جو بہت سے لوگوں کو ذہانت کی طرح نظر آیا۔
سوال اب یہ نہیں تھا “کیا مشینیں سوچ سکتی ہیں؟”
سوال بن گیا “کیوں کچھ جو صرف متن کی پیش گوئی کے لیے تربیت یافتہ ہے، سوچتا ہوا نظر آتا ہے؟”
ابھرتی ہوئی صلاحیتیں: جب اسکیل رویہ پیدا کرتا ہے جس کی کسی نے توقع نہیں کی
LLMs کے بڑے رازوں میں سے ایک یہ ہے کہ کچھ صلاحیتیں صرف مخصوص سائز سے آگے آتی ہیں۔
Below a threshold, a model:
Performs badly on logic puzzles.Struggles with math.Fails at code.Can’t translate well.
حد عبور کریں — اکثر صرف سائز بڑھا کر — اور اچانک ماڈل:
Solves riddles.Performs basic algebra.Writes working code.Translates dozens of languages.Passes professional exams.
اس مظہر کو ابھار کہا جاتا ہے۔
یہ متنازعہ ہے — کچھ محققین کا کہنا ہے کہ یہ ہموار بہتری ہیں جو "تیز چھلانگوں" کے طور پر غلط سمجھا جاتا ہے۔ لیکن عملی طور پر، بہت سی صلاحیتیں واقعی اچانک ظاہر ہوتی ہیں جب صلاحیت بڑھتی ہے۔
یہ ان وجوہات میں سے ایک ہے جن کی وجہ سے سائنسدان کہتے ہیں کہ ہم LLMs کو مکمل طور پر نہیں سمجھتے:
We can’t yet predict which capabilities will appear at which scale.
یہ ایسے ہے جیسے آپ نے ایک بڑا دوربین بنایا اور یہ خود بخود مثلثیات سیکھ گیا۔
متن سے سب کچھ: ملٹی موڈل ٹرانسفارمرز
اگلا قدم متن سے آگے کی توسیع تھا۔
تحقیقی ماہرین نے محسوس کیا:
If transformers model sequences of tokens, why not convert every kind of data — images, audio, video — into tokens?
یہ بصیرت ملٹی موڈل ماڈلز کی طرف لے گئی:
Vision transformers (ViT) for images.Audio transformers for speech.Multimodal LLMs that handle images and text in one model.Video models now starting to emerge.
ٹرانسفارمرز نے اس میدان کو یکجا کر دیا۔
ہر قسم کے ڈیٹا کے لیے مخصوص آرکیٹیکچرز کے بجائے، ہم اب ایک بنیادی انجن کا استعمال کرتے ہیں تاکہ سب کچھ پروسیس کیا جا سکے۔
یہ تبدیلی 20ویں صدی میں ہر آلے میں بجلی کے انضمام کی طرح گہری ہے۔ جب سب کچھ "ٹوکنز" بن گیا، تو ٹرانسفارمرز مختلف ڈومینز میں سیکھنے کے قابل ہو گئے۔
کیوں ٹرانسفارمرز نے فتح حاصل کی
وجوہات کا خلاصہ:
1. They scale endlessly.The more compute you give them, the better they get.
2. They parallelize perfectly.Modern GPUs love transformers.
3. They learn long-range structure.Self-attention captures relationships across thousands of tokens.
4. They unify all modalities.Images, text, audio — all become token sequences.
5. They produce emergent behavior.Capabilities appear naturally as models grow.
In short:
Transformers turned AI progress from a theoretical discipline into an engineering problem.And once something becomes an engineering problem, scale takes over.
2017–2020 کیمبرین دھماکہ تھا
صرف تین سالوں میں:
Transformers were invented (2017).GPT-1 arrived (2018).GPT-2 shocked the world (2019).GPT-3 triggered global awareness (2020).
یہ جدید تاریخ میں کسی بھی بڑے تکنیکی میدان کی سب سے تیز تبدیلی ہے۔ کچھ بھی نہیں — نہ بجلی، نہ انٹرنیٹ، نہ اسمارٹ فونز — اس رفتار سے آگے بڑھا۔
اور پھر بھی، یہ صرف آغاز تھا۔
اگلا مرحلہ (2021–2025) لائے گا:
Fine-tuning (RLHF).Instruction-following models.Large commercial deployments.Code-generation systems.Multimodal assistants.Agentic behavior.Models trained to reason, not just predict.
The Instruction-Following Revolution (2020–2025)
کیسے LLMs "آٹو کمپلیٹ آن اسٹیرائڈز" سے ایسے نظاموں میں تبدیل ہوئے جو واقعی آپ کی درخواست پر عمل کرتے ہیں
2020 کے وسط میں GPT-3 کا اجرا محققین، صنعت کے رہنماؤں، اور عام لوگوں کو حیران کر دیا۔ لیکن اگر آپ نے براہ راست ابتدائی GPT-3 کا استعمال کیا تو آپ کو جلد ہی ایک مسئلے کا سامنا کرنا پڑا:
GPT-3 متن پیدا کرنے میں شاندار تھا، لیکن یہ ہدایات پر عمل نہیں کرتا تھا.
آپ پوچھ سکتے تھے:
“Summarize this in one sentence.”
اور یہ شاید:
Summarize,Or write a poem about summarization,Or launch into a fictional narrative,Or ignore the request entirely.
GPT-3 "نافرمان" نہیں تھا — یہ صرف اطاعت کے تصور کو کبھی نہیں سیکھا۔ اسے صرف وسیع انٹرنیٹ متن کی بنیاد پر اگلا ٹوکن پیش گوئی کرنے کے لیے تربیت دی گئی تھی۔ انٹرنیٹ میں گفتگو، مضامین، کوڈ، اور دلائل کے پیٹرن موجود ہیں — لیکن یہ نہیں رکھتا "اس فارمیٹ کا استعمال کرتے ہوئے صارف کی ہدایات کا جواب دینے" کا مستقل پیٹرن۔
دنیا کو ایک نئے تربیتی مرحلے کی ضرورت تھی۔
ایک ایسا جو وحشی، تخلیقی صلاحیت کو کچھ کنٹرول کرنے کے قابل بنائے۔
یہ جدید AI میں سب سے اہم اختراعات میں سے ایک کی پیدائش کا باعث بنا:
انسانی فیڈبیک سے تقویت سیکھنا (RLHF)
RLHF نے بنیادی طور پر بڑے زبان ماڈلز کے لوگوں کے ساتھ تعامل کرنے کے طریقے کو تبدیل کر دیا۔
یہ تین بڑے مراحل میں کام کرتا ہے:
1. اچھے رویے کی مثالیں جمع کریں
انسان مختلف سوالات کے جواب لکھتے ہیں:
“Explain quantum mechanics to a 7th grader.”“Write a polite customer service email.”“Don’t give harmful advice.”“Follow step-by-step reasoning.”
یہ انسانوں کے لکھے ہوئے مثالیں ایک "ٹیچر سیٹ" بناتی ہیں۔
2. انعام ماڈل کی تربیت کریں
ایک اور ماڈل یہ جانچنے کے لیے تربیت دی جاتی ہے کہ جواب کتنا اچھا ہے۔ یہ ماڈل ایک قسم کی ترجیحات کی تقریب سیکھتا ہے: کیا جواب ہدایات کی پیروی کرتا ہے؟ کیا یہ مددگار ہے؟ کیا یہ محفوظ ہے؟
3. بنیادی ماڈل کو بہتر بنانے کے لیے تقویت سیکھنے کا استعمال کریں
بنیادی ماڈل جوابات پیدا کرتا ہے۔
انعام ماڈل انہیں اسکور کرتا ہے۔
RL الگورڈم بنیادی ماڈل کو اسکور کو زیادہ سے زیادہ کرنے کے لیے ایڈجسٹ کرتا ہے۔
آخری نتیجہ حیرت انگیز طور پر طاقتور ہے:
The model becomes obedient.It answers questions directly.It refrains from harmful content.It adopts a consistent style.It becomes a conversational agent rather than a text generator.
بغیر RLHF کے، ChatGPT موجود نہیں ہوتا۔
بغیر RLHF کے، جدید AI اب بھی ایک کھلونا ہوتا۔
یہ وہ لمحہ ہے جب LLMs مددگار بن گئے۔
ہدایات کی ترتیب: دوسرا بڑا انقلابی قدم
تقریباً اسی وقت، ایک اور تکنیک ابھری جسے ہدایات کی ترتیب کہا جاتا ہے۔
تقویت سیکھنے کے بجائے، ہدایات کی ترتیب صرف بڑے ڈیٹا سیٹس جمع کرتی ہے:
Questions → AnswersCommands → ExecutionsInstructions → Successful completions
ہزاروں (بعد میں لاکھوں) ان مثالوں پر بنیادی ماڈل کو بہتر بنا کر، ماڈلز نے "صارف کی نیت کی پیروی" کے تصور کو عام کرنا شروع کیا۔
سب سے مشہور ہدایات کی ترتیب والا ڈیٹا سیٹ ابتدائی طور پر FLAN (فائن ٹیونڈ لینگویج نیٹ) تھا، جو گوگل نے بنایا۔ OpenAI نے اسی طرح کے لیکن ملکیتی ڈیٹا سیٹس کا استعمال کیا۔
ہدایات کی ترتیب نے LLMs کو سکھایا:
How to be consistent.How to interpret tasks.How to avoid rambling.How to format responses clearly.How to solve problems step-by-step.
جب اسے RLHF کے ساتھ ملا دیا گیا، تو اس نے حقیقی طور پر قابل استعمال LLM پر مبنی مددگاروں کی پہلی نسل پیدا کی۔
عوامی آغاز: ChatGPT (دیر 2022)
وہ لمحہ جب دنیا جاگ اٹھی
30 نومبر 2022 کو، OpenAI نے خاموشی سے ایک تحقیقی پیش نظارہ جاری کیا جسے ChatGPT کہا جاتا ہے۔
یہ ان کا سب سے بڑا ماڈل نہیں تھا۔
یہ ان کا سب سے ذہین ماڈل نہیں تھا۔
یہ ان کا سب سے نیا ماڈل نہیں تھا۔
لیکن یہ پہلا ماڈل تھا جو RLHF اور ہدایات کی ترتیب کے ساتھ بھاری تربیت دیا گیا — اور اسے ایک چیٹ انٹرفیس دیا گیا جو عام لوگوں کے لیے ڈیزائن کیا گیا تھا۔
چند دنوں کے اندر، یہ وائرل ہو گیا۔
ChatGPT became:
The fastest-growing product in historyThe first AI tool used at global scaleA mainstream cultural event
پہلی بار، اوسط شخص نے ایک مشین کے ساتھ بات چیت کی جو:
Holding conversationsWriting essaysDebugging codeExplaining scientific conceptsDrafting business emailsSimulating personalitiesActing as a study partnerSummarizing long textsAnswering philosophical questions
AI کے بارے میں عوامی تصور ایک رات میں بدل گیا۔
جو ایک دور دراز تصور تھا — "کبھی نہ کبھی AI طاقتور ہوگا" — وہ ٹھوس، فوری، اور ذاتی بن گیا۔
کوڈ ماڈلز: جب AI نے پروگرامنگ سیکھا
زبان کے ماڈلز صرف الفاظ کے ساتھ اچھے نہیں ہیں۔
پروگرامنگ زبانیں، اپنی بنیاد میں، انتہائی منظم متن کی شکلیں ہیں۔
تو جب LLMs نے ترقی کی، تو وہ ان میں بہت اچھے ہو گئے:
Completing code,Fixing bugs,Explaining errors,Generating entire functions,Translating code between languages.
OpenAI نے Codex کی تربیت کی، جو GPT-3 کی نسل ہے، جو پروگرامنگ میں مہارت رکھتا ہے۔ اس نے GitHub Copilot کی طرف لے جایا — جو کہ واقعی میں تجارتی طور پر تبدیلی لانے والے AI مصنوعات میں سے ایک ہے۔
ڈویلپرز نے جلد ہی محسوس کیا:
Code autocompletion is now superhuman.AI can write boilerplate instantly.AI can explain cryptic errors.AI can refactor code safely.AI can pair-program with humans 24/7.
کوڈنگ کے معاونین وہ پہلے شعبے ہو سکتے ہیں جہاں LLMs واقعی میں عام انسانی کارکردگی سے آگے بڑھتے ہیں عملی کام میں۔
اس نے LLMs کو صرف متن کے اوزار نہیں بلکہ منظم زبانوں پر عمومی استدلال کی مشینیں بنا دیا۔
ملٹی موڈلٹی: جب LLMs نے دیکھنا اور سننا سیکھا
ٹرانسفارمر کا ڈھانچہ تسلسل کے لیے ڈیزائن کیا گیا تھا۔
تو اگر آپ تصاویر، آڈیو، یا ویڈیو کو تسلسل میں تبدیل کرتے ہیں…
تو ٹرانسفارمر بھی ان سے سیکھ سکتے ہیں۔
2023–2024 تک، ماڈلز ملٹی موڈل بن گئے:
They could analyze images.They could describe photos.They could solve math problems written on paper.They could transcribe and interpret audio.They could generate images from text.
ٹرانسفارمر انسانی علم کے لیے عالمی انٹرفیس بن چکا تھا۔
یہ اب "زبان AI" نہیں رہا۔
یہ عمومی مصنوعی ادراک کی شروعات تھی۔
ایجنٹس: جب LLMs نے دنیا میں عمل کرنا شروع کیا
جب LLMs ہدایات پر عمل کر سکتے تھے، تو ڈویلپرز نے انہیں اوزار دینا شروع کر دیے:
CalculatorsBrowsersFile systemsAPIsCode interpreters
اچانک، LLMs کر سکتے تھے:
Look up real informationExecute tasksWrite and run codeQuery databasesPerform workflowsAutomate entire processes
یہ ایجنٹک AI کی صبح کا نشان تھا — ایسے نظام جو:
Observe the environmentFormulate plansExecute actionsIterate based on feedback
ہمیں ابھی تک خود مختار عمومی مقصد ایجنٹس بڑے پیمانے پر نہیں ملے ہیں، لیکن ابتدائی ورژن پہلے ہی موجود ہیں:
AI personal assistantsAI research helpersAI workflow automatorsAI system managers
یہ اگلی انقلاب کی شروعات ہے: وہ دنیا جہاں AI صرف متن پیدا نہیں کرتا، بلکہ واقعی کام کرتا ہے۔
ہم آہنگی: AI کے رویے کا بڑھتا ہوا مسئلہ
The more capable LLMs became, the more urgent the question became:
How do we ensure these systems behave safely?
ایل ایل ایمز کر سکتے ہیں:
Spread misinformationReinforce biasesGenerate harmful instructionsProduce hallucinated factsMisinterpret commandsBe manipulated through adversarial prompts
آر ایل ایچ ایف اور ہدایت کی ترتیب کی وجہ سے، وہ اکثر مددگار، محفوظ معاونین کی طرح برتاؤ کرتے ہیں — لیکن ہم آہنگی ایک متحرک ہدف ہے۔
ایل ایل ایمز ساکن نہیں ہیں۔
یہ ترقی پذیر نظام ہیں جو مراعات، تربیتی ڈیٹا، اور صارف کے تعاملات سے تشکیل پاتے ہیں۔
ان کے برتاؤ کو سمجھنا، پیش گوئی کرنا، اور کنٹرول کرنا اب اس میدان کے مرکزی چیلنجوں میں سے ایک ہے۔
ہم جانتے ہیں کہ انجن کیسے بنانا ہے۔
ہم ابھی تک مکمل طور پر نہیں جانتے کہ اس کا انتظام کیسے کرنا ہے۔
2020–2025 کا دھماکہ
صرف پانچ سالوں میں، اے آئی نے پچھلے 70 سالوں کی نسبت زیادہ خلل کا سامنا کیا:
2020: GPT-3 shocks the research world.2021: Codex introduces practical AI coding.2022: ChatGPT brings LLMs to the masses.2023: Multimodal GPT-4 arrives.2024: Agent frameworks emerge.2025: Industry, government, media, and finance begin reorganizing around AI-first workflows.
ہر بڑی صنعت — قانون سے لے کر صحت کی دیکھ بھال، لاجسٹکس، اور سیاست تک — اب ایل ایل ایمز کو روزمرہ کی کارروائیوں میں شامل کر رہی ہے۔
ہم انسانی تاریخ میں کسی بھی ٹیکنالوجی کی سب سے تیز اپنائیت کی لہر میں جی رہے ہیں۔
لیکن جو کچھ آگے آتا ہے وہ اس سے بھی زیادہ اہم ہے۔
حصہ VI یہ جانچ کرے گا کہ ایل ایل ایمز کہاں جا رہے ہیں:
scaling limits,interpretability breakthroughs,autonomous systems,AI-native economies,and the question of whether we are approaching something like general intelligence.
The Next Decade of Large Language Models (2025–2035)
ہم کہاں جا رہے ہیں، ہمیں ابھی تک کیا سمجھ نہیں آیا، اور وہ تہذیب کا راستہ جسے اے آئی دوبارہ شکل دینے والی ہے
2025 میں کھڑے ہو کر، یہ واضح ہے کہ پچھلے پانچ سال بڑے زبان ماڈلز کا عروج نہیں تھے، بلکہ یہ ایک پیش لفظ تھے۔
ٹرانسفارمرز نے ہمیں ایسے نظام فراہم کیے جو بول سکتے ہیں، لکھ سکتے ہیں، کوڈ کر سکتے ہیں، استدلال کر سکتے ہیں، اور محسوس کر سکتے ہیں — یہ سب بڑے ڈیٹا سیٹس سے شماریاتی پیٹرن سیکھ کر۔ لیکن یہ صلاحیتیں اختتام نہیں ہیں۔ یہ اگلی ٹیکنالوجی دور کے لیے کم از کم قابل عمل بنیاد ہیں۔
جس طرح ابتدائی انسانی زبان نے ثقافت، تعاون، اور تہذیب کو ممکن بنایا، مصنوعی زبان کی روانی معاشرے میں ایک نئی سطح کی ادراک کو فعال کر رہی ہے — جو کہ قابل توسیع، بے تھک، اور عالمی معیشت کی ہر سطح پر مربوط ہے۔
اگلا دہائی چیٹ بوٹس کے بارے میں نہیں ہوگی۔
یہ ان سب چیزوں کی تبدیلی کے بارے میں ہوگی جن کو وہ چھوتے ہیں۔
یہ سمجھنے کے لیے کہ آگے کیا ہوتا ہے، ہمیں پانچ بڑے سرحدوں کی کھوج کرنی ہوگی:
- پیمانہ — ہم ماڈل کے سائز اور ڈیٹا کو کتنی دور تک بڑھا سکتے ہیں جب تک کہ ہم جسمانی حدود کو نہ پہنچیں؟
- تشریح — کیا ہم ان ماڈلز کے اندر کیا ہو رہا ہے کو سمجھ سکتے ہیں؟
- ہائبرڈ استدلال — علامتی ٹولز کو نیورل نیٹ ورکس کے ساتھ ملا کر۔
- ایجنٹس — ایل ایل ایمز جو خود مختاری سے عمل کرتے ہیں، منصوبہ بندی کرتے ہیں، عملدرآمد کرتے ہیں، اور کام کرتے ہیں۔
- تہذیبی انضمام — اے آئی معیشتوں، حکمرانی، اور علم کے نظام کو کیسے دوبارہ شکل دے گی۔
آئیے ہر ایک کے ذریعے چلتے ہیں۔
1. پیمانہ: جدید اے آئی دور کا پہلا اصول
جدید ایل ایل ایم کی ترقی ایک بے حد سادہ فارمولے سے چلتی ہے:
زیادہ پیرامیٹرز + زیادہ ڈیٹا + زیادہ کمپیوٹ → زیادہ صلاحیت۔
یہ کوئی مبہم قاعدہ نہیں ہے — یہ ایک ماپنے والا تجرباتی قانون ہے۔ 2020 میں دریافت کردہ پیمانے کی منحنی خطوط آج اے آئی کی پیش گوئی کا بنیادی ڈھانچہ ہیں۔ ہر بڑی لیبارٹری اب ایسے روڈ میپ بناتی ہے جو پیمانے کے گرد مرکوز ہیں۔
لیکن ہم کتنی دور تک پیمانہ بڑھا سکتے ہیں؟
کئی پابندیاں ہیں:
A. حساب کریں:
عالمی معیار کی تربیت کے لیے پہلے ہی کئی مہینوں تک چلنے والے ہزاروں GPUs کی ضرورت ہوتی ہے۔ لیکن ہارڈ ویئر تیز ہو رہا ہے:
Next-gen GPUs (Blackwell, Rubin, etc.)Photonic and optical acceleratorsASICs built specifically for transformersChiplet-based interconnectsAI supercomputers funded by national governments
حساب میں ایک یا دو اور درجے کا اضافہ ہوگا جب تک کہ جسمانی حدود نہ پہنچ جائیں۔
B. ڈیٹا:
ہم اعلیٰ معیار کے انسانی متن کی کمی محسوس کر رہے ہیں۔
لیکن کئی حل ابھر رہے ہیں:
Synthetic data generated by LLMs (self-eating datasets)Multimodal data (images, audio, video)Reinforcement-learning-based dataSimulation-generated dataDigitization of offline archives
یہ خیال کہ "انٹرنیٹ ڈیٹا سے خالی ہو جائے گا" اس بات کی کم قیمت لگاتا ہے کہ انسانی ادارے کتنی تیزی سے نئے تربیتی کارپوری پیدا کر رہے ہیں۔
C. ماڈل کی تعمیر:
آج کل ٹرانسفارمرز غالب ہیں، لیکن نئے ڈھانچے (ماہرین کا مرکب، RWKV، توجہ سے آزاد ٹرانسفارمرز، ریاستی جگہ کے ماڈل) ابھر رہے ہیں جو زیادہ مؤثر طریقے سے اسکیل کرتے ہیں۔
کیا اسکیلنگ حل نہیں کرتی
اسکیلنگ عمومی صلاحیت میں اضافہ کرتی ہے — لیکن یہ بنیادی طور پر حل نہیں کرتی:
HallucinationsMisalignmentLack of groundingLack of internal interpretabilityPoor planning or memoryWeak world models
مستقبل کے LLMs بڑے ہوں گے، لیکن بڑی ہونا آخری مقصد نہیں ہے۔ صلاحیت میں بہتری ضروری ہے، لیکن کافی نہیں۔
2. تشریح: مشین کے دماغ کو پڑھنا سیکھنا
اس وقت، بڑے زبان کے ماڈل کوڈ میں شفاف ہیں لیکن ادراک میں غیر شفاف ہیں۔
ہم ہر وزن کو دیکھ سکتے ہیں۔
ہم ہر ایکٹیویشن کا معائنہ کر سکتے ہیں۔
ہم ہر گریڈینٹ کی پیمائش کر سکتے ہیں۔
پھر بھی ہم انہیں مکمل نقشے میں تبدیل نہیں کر سکتے:
ConceptsSubroutinesReasoning pathwaysLatent world models
یہ میکانکی تشریح کی سرحد ہے، جو اہمیت میں پھٹ رہی ہے۔
تشریح کیوں اہم ہے
جب LLMs مالیاتی مارکیٹوں، فوجی نظاموں، طبی ورک فلو، اور حکومتی کارروائیوں میں ضم ہوتے ہیں، تو انہیں سمجھنا ضروری ہو جاتا ہے۔
تشریح یہ طے کرے گی:
SafetyTrustRegulationReliabilityAccountability
دو امید افزا پیشرفتیں ابھر رہی ہیں:
A. فیچر پر مبنی تشریح
ماڈلز "فیچرز" میں معلومات ذخیرہ کرتے نظر آتے ہیں — نیورونز کے کلسٹر جو نمائندگی کرتے ہیں:
Abstract concepts (“danger,” “sarcasm,” “plan continuation”)Structures (HTML tags, programming loops, sentence boundaries)Behavioral tendencies (“be concise,” “avoid harm,” “justify steps”)
ہم پہلے ہی کچھ فیچرز کو الگ کر سکتے ہیں۔
B. سرکٹ کی سطح کی تشریح
نیورونز کے درمیان معلومات کے بہاؤ کا تفصیلی نقشہ۔ یہ دماغ میں مائیکرو سرکٹس کی شناخت کے مترادف ہے۔
طویل مدتی مقصد نیورل نیٹ ورکس کے لیے ایک روزیٹا اسٹون ہے — ایک مکمل ترجمہ کی تہہ جو ہمیں ماڈل کی داخلی حسابات کو سورس کوڈ کی طرح پڑھنے کی اجازت دیتی ہے۔
یہ دہائیاں لے سکتا ہے۔
یا یہ ہمیں حیران کر سکتا ہے اور چند سالوں میں پہنچ سکتا ہے۔
کسی بھی صورت میں، تشریحی صلاحیت ہمارے بنائے گئے نظام کو سمجھنے میں اگلا ضروری قدم ہے۔
3. ہائبرڈ استدلال: نیورل اور علامتی ذہنوں کا انضمام
ایک خالص LLM ایک شماریاتی مشین ہے۔ یہ پیٹرن کی پیش گوئی کرتا ہے۔ لیکن یہ نہیں کرتا:
maintain long-term memory,execute symbolic logic reliably,use mathematical proofs,perform multi-step reasoning with guarantees,or model the world explicitly.
یہ بدل رہا ہے۔
مستقبل نیورل-علامتی انضمام ہے۔
ہائبرڈ نظام کیا ملاتے ہیں
LLMs فراہم کرتے ہیں:
language fluencygeneral world knowledgecreativitycontextual reasoningrobust generalization
علامتی نظام فراہم کرتے ہیں:
exact reasoningdeterministic logicprovable correctnessprecision memorytool execution
پہلے سے ابھرتی ہوئی مثالیں
LLMs + search engines → grounded reasoningLLMs + calculators → exact mathLLMs + code interpreters → reliable workflowsLLMs + database queries → factual correctnessLLMs + robotics → real-world interactionLLMs + simulation engines → long-horizon planning
یہ ہائبرڈ فن تعمیر انسانی ادراک کے قریب ترین تشبیہ ہے:
Neural networks for intuitionSymbolic logic for precision
فرق یہ ہے کہ ہمارے ہائبرڈ نظام انسانی صلاحیت سے کہیں زیادہ بڑھ جائیں گے۔
4. ایجنٹس: پیش گوئی اور عمل کے درمیان پل
آج کے LLMs ردعمل دینے والے ہیں — یہ پوچھے جانے پر متن تیار کرتے ہیں۔
ایجنٹس پیشگی عمل کریں گے۔
AI ایجنٹ کی تعریف کیا ہے
It observes an environmentIt forms internal goalsIt creates plansIt takes actionsIt evaluates the outcomeIt updates strategies over time
LLMs پہلے ہی یہ کرنے کی صلاحیت رکھتے ہیں:
Autonomous software engineeringData analysisWeb searchSimulation-based decision makingPlanning and task execution
جب وہ یادداشت، اوزار، اور خود مختاری حاصل کریں گے، ایجنٹس بن جائیں گے:
Executive assistantsResearch partnersMedical analystsFinancial plannersOperations managersScientific collaboratorsSoftware architects
کچھ ملازمین کی طرح عمل کریں گے۔
کچھ تنظیموں کی طرح عمل کریں گے۔
کچھ پوری کمپنیوں کی طرح عمل کریں گے۔
یہ معیشت، حکمرانی، اور اخلاقیات کے لیے بڑے سوالات اٹھاتا ہے۔
5. AI-نیٹو تہذیب: LLMs کس طرح معاشرے کو دوبارہ شکل دیں گے
اگلی دہائی "ملازمتوں کی تبدیلی" سے نہیں بلکہ بڑی زبان ماڈلز کی طرف سے ممکنہ گہرائی کے ڈھانچوں کی تبدیلیوں سے متعین ہوگی۔
A. AI-نیٹو محنت
انسانی تاریخ میں پہلی بار، خود ادراک ایک مال بن رہا ہے:
researchwritingcodingdesignproject managementanalysissynthesisstrategic planning
یہ کام کبھی انسانی گھنٹوں تک محدود تھے۔
اب یہ مشین کی رفتار اور قیمت پر بڑھتے ہیں۔
B. AI-نیٹو سائنس
LLMs بن جائیں گے:
hypothesis generatorsdata interpreterssimulation designersliterature reviewerslab workflow managers
سائنس میں رکاوٹ "انسان کیا سمجھ سکتے ہیں؟" سے "انسان کیا تصدیق کر سکتے ہیں؟" کی طرف منتقل ہوتی ہے۔
C. AI-نیٹو حکومت
ادارے بڑھائیں گے:
lawmakingregulationtaxationdiplomacydefenseintelligence analysisinfrastructure planning
AI کے طور پر کام کرے گا:
advisorsimulatorpolicy evaluatorwatchdogred-team actor
وہ ممالک جو LLMs کو مؤثر طریقے سے ضم کرتے ہیں، وہ ان ممالک سے آگے نکل جائیں گے جو ایسا نہیں کرتے۔
D. AI-نیٹو معیشت
معیشتیں بڑھتی ہوئی طور پر کام کریں گی:
algorithmic speedsAI-optimized logisticsAI-managed supply chainsAI-powered investment strategiesAI-driven demand forecasting
کارپوریشنز اسکیل انٹیلیجنس کے تیز کرنے والے بن جاتے ہیں، نہ کہ صرف اسکیل کیپیٹل کے۔
E. AI-نیٹو علم کی ثقافت
علم کی تخلیق تیز ہوتی ہے:
new booksnew theoriesnew mathematical proofsnew engineering designsnew music and artnew cultural forms
یہ سب سے غیر متوقع سرحد ہے، کیونکہ نئے ذہانت کے نظام ہمیشہ اظہار کے نئے طریقے تخلیق کرتے ہیں۔
کیا ہم عمومی ذہانت کے قریب پہنچ رہے ہیں؟
یہ سب سے متنازعہ سوال ہے، لیکن ایک لازمی سوال ہے۔
آج کے LLMs AGI نہیں ہیں۔
یہ شعور نہیں رکھتے۔
یہ خود آگاہی نہیں رکھتے۔
لیکن یہ ظاہر کرتے ہیں:
transfer learningreasoningplanningdeception (unintended)creativitycomplex problem solvingtool usereflection-like behavioremergent knowledge structures
یہ خصوصیات عمومی ذہانت کے ادراکی پروفائل کی طرح نظر آنا شروع ہو رہی ہیں — انسانی جیسی نہیں، بلکہ فعالی۔
یہ ممکن ہے کہ AGI ایک واحد بریک تھرو کے طور پر نہیں آئے گا، بلکہ:
larger modelsricher multimodalitybetter tool integrationstronger memoryhybrid reasoningmore autonomous agents
سوال یہ نہیں ہے کہ AGI ممکن ہے یا نہیں — بلکہ یہ ہے کہ کیا ہم اسے پہچانیں گے جب یہ آئے گا۔
Conclusion: The Long Arc from 1940s Radar to 2030s Digital Minds
اگر ہم پیچھے ہٹیں تو وقت کا خاکہ واضح ہو جاتا ہے:
Early mathematicians (Markov, Shannon) invented the core idea of sequence modeling.Cold War computers operationalized it for radar and signals.Symbolic AI tried and failed to encode meaning manually.Statistical models rediscovered Shannon’s vision.Neural networks learned semantic structure.Transformers unlocked scale.RLHF unlocked usability.Agents will unlock autonomy.Hybrid systems will unlock reliability.Interpretability will unlock trust.Civilization will unlock a new layer of intelligence.
LLMs کا راستہ اچانک دھماکے کی طرح نہیں ہے — یہ خیالات کی ایک صدی طویل ترقی ہے جو ایک واحد، متحد ٹیکنالوجی میں مل رہی ہے۔
ہم ابھی بھی ان نظاموں کو اندرونی طور پر مکمل طور پر نہیں سمجھتے۔
ہم ابھی بھی ان کی تصوری زبان کو ڈیکوڈ نہیں کر سکتے۔
ہم ابھی بھی ابھرتی ہوئی صلاحیتوں کی پیش گوئی نہیں کر سکتے۔
لیکن ایک چیز یقینی ہے:
اگلی دہائی اس بات سے تشکیل پائے گی کہ AI آج کیا کر سکتا ہے، بلکہ اس بات سے کہ جب ہم ان ذہنوں کے ساتھ سمجھنے، کنٹرول کرنے اور تعاون کرنے کا طریقہ سیکھیں گے تو کیا ممکن ہو جائے گا۔
یہ بڑی زبان ماڈلز کی کہانی ہے — نہ کہ الگ الگ اشیاء کے طور پر، بلکہ ایک طویل تاریخی قوس کی توسیع کے طور پر، اور ایک نئے کی شروعات کے طور پر۔
بڑی زبان ماڈلز ایسے محسوس ہوتی ہیں جیسے یہ کہیں سے پھٹ پڑی ہیں — ایک دن ہمارے فون بمشکل خودکار درست کر سکتے تھے، اگلے دن ہم ایسے نظاموں سے بات کر رہے ہیں جو کوڈ لکھتے ہیں، امتحانات پاس کرتے ہیں، اور فلسفے پر بحث کرتے ہیں۔ لیکن اندر کی جانب، آج کا AI اچانک معجزہ نہیں ہے؛ یہ ایک صدی طویل کہانی کا تازہ ترین باب ہے جو ایک دھوکہ دہی سے سادہ خیال کے بارے میں ہے: جو کچھ آپ نے اب تک دیکھا ہے، اس کے پیش نظر، اگلی سب سے ممکنہ چیز کیا ہے؟
یہ مضمون اس پوری قوس کے ذریعے چلتا ہے — ابتدائی احتمال کے نظریے اور سرد جنگ کے ریڈار کنسولز سے لے کر ELIZA، شماریاتی زبان ماڈلز، نیورل نیٹ ورکس، ٹرانسفارمرز، اور ہدایت سے ترتیب دیے گئے چیٹ بوٹس تک — یہ دکھانے کے لیے کہ ایک قدیم ریاضیاتی چال، جو کھربوں الفاظ اور اربوں پیرامیٹرز میں پھیلائی گئی، خاموشی سے کچھ ایسا بن گئی جو عمومی استدلال کی طرح لگتا ہے۔ راستے میں، ہم ایک سخت حقیقت کا سامنا کرتے ہیں: ہم جانتے ہیں کہ ان ماڈلز کو کیسے بنانا ہے، لیکن ہم ابھی بھی مکمل طور پر نہیں سمجھتے کہ وہ اندر کیا کر رہے ہیں۔ یہ میکانزم اور معنی کے درمیان کا فرق ہے جہاں AI کی اگلی دہائی — اور ہمارے بہت سے سماجی انتخاب — طے کیے جائیں گے۔
ذرائع
ہائپر لنکس یہاں صرف فراہم کیے گئے ہیں، پیٹرن نیکسس کے طرز کے مطابق متن میں کوئی بیرونی لنک نہیں ہے۔
- انڈری مارکوف کا مارکوف چینز پر بنیادی کام — https://en.wikipedia.org/wiki/Markov_chain
- کلاڈ شینن، "ایک ریاضیاتی نظریہ برائے مواصلات" (1948) — https://people.math.harvard.edu/~ctm/home/text/others/shannon/entropy/entropy.pdf
- MIT Whirlwind I اور ابتدائی حقیقی وقت کی ڈیجیٹل کمپیوٹنگ — https://www.computerhistory.org/revolution/real-time-computing/6/131
- SAGE فضائی دفاعی نیٹ ورک اور سرد جنگ کے ریڈار کمپیوٹنگ — https://www.computerhistory.org/revolution/air-defense/16/180
- آپریشن آئیگلو وائٹ — ویتنام دور کے سینسر نیٹ ورکس — https://en.wikipedia.org/wiki/Operation_Igloo_White
- جوزف ویزن بام کا ELIZA (1966) — https://en.wikipedia.org/wiki/ELIZA
- ٹیری وینوگراڈ کا SHRDLU — https://en.wikipedia.org/wiki/SHRDLU
- شماریاتی NLP اور n-gram زبان ماڈلز کا جائزہ — https://nlp.stanford.edu/~wcmac/papers/20050421-snlp.pdf
Article overview
ایک صدی کی طویل تاریخ بڑی زبان کے ماڈلز کی—ابتدائی احتمال کے نظریات اور سرد جنگ کی کمپیوٹنگ سے لے کر نیورل نیٹ ورکس، ٹرانسفارمرز، اسکیلنگ قوانین، اور جدید AI کے ابھار تک۔ LLMs کی حقیقی ترقی کی ایک گہری Pattern Nexus کی تلاش۔
آپ کا ردعمل کیا ہے؟
 پسند کریں
0
 نہ پسند
0
 محبت
0
 مزاحیہ
0
 واہ
0
 اداس
0
 غصہ
0

Nexus (Christopher)
Founder of Pattern Nexus. I research markets, macro, geopolitics, AI, history, ancient systems, and the patterns most people overlook. I’m also building Market Radar, a trading scanner designed to read pressure, risk, confirmation, and setup quality before ch…
Related research
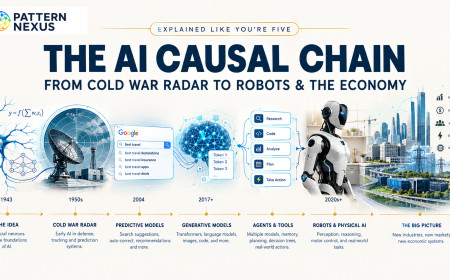
AI کی وجہی زنجیر کی وضاحت ایسے کریں جیسے آپ پانچ سال کے ہوں: سرد جنگ کے ریڈار سے لے کر روبوٹ اور معیشت تک
AI کا آغاز ChatGPT سے نہیں ہوا۔ یہ قابل رسائی، مکمل طور پر ماخذ شدہ Pattern Nexus تحقیق کا نقشہ 1943 کے مصنوعی نیورون کے مقالے، سرد جنگ کے …
5 shared topics.
کمانڈ لائن — آڈیو-ویڈیو ایڈیشن
ہفتہ وار پیٹرن نیكسس آڈیو-ویڈیو سیریز کا قسط 3 سائیکلز آف پاور کے حصہ 3 کو ایک مختصر کہانی میں تبدیل کرتا ہے کہ کس طرح ڈارٹ ماؤتھ، انٹیگریٹ…
4 shared topics.
امریکہ کا نیا طاقت کا نقشہ 2026: ڈیٹا سینٹرز، گرڈ کی درجہ بندی، اور وہ ردعمل جو AI کی تعمیر کو نہیں روک سکے گا۔
AI ڈیٹا سینٹر کا عروج اب مجرد ٹیک ہائپ سے جسمانی بنیادی ڈھانچے کے تنازعے میں منتقل ہو چکا ہے۔ نقشہ اب سب اسٹیشنز، پانی کی میزوں، ٹرانسمیشن …
4 shared topics.
گوگل کا خلا میں مبنی AI ڈیٹا سینٹر منصوبہ: پروجیکٹ سنکچر اور نئی کمپیوٹ سرحد
گوگل نے پہلے خلا میں مبنی AI ڈیٹا سینٹر کنسٹیلیشن بنانے کے منصوبے کا انکشاف کیا ہے — ایک شمسی توانائی سے چلنے والا مداری کمپیوٹ کلسٹر جو زم…
4 shared topics.
AI کمپیوٹ اور پاور انفراسٹرکچر 2025 میں — نئی صنعتی ریڑھ کی ہڈی
ایک گہری پیٹرن نیکسس کی تحقیقات 2025 کے AI صنعتی تعمیرات پر — ہر بڑے کمپیوٹ معاہدے، ہائپر اسکیلر کی توسیع، اور مشینی ذہانت کے لیے توانائی ک…
4 shared topics.
ایمیزون نے اینوڈیا جی پی یوز کو 2028 کے AI-فیکٹری سپلائی لائن میں تبدیل کر دیا
AWS اور Nvidia 2027 اور 2028 میں AWS کے عالمی بنیادی ڈھانچے میں 2 ملین اضافی Nvidia GPUs تعینات کرنے کا منصوبہ بنا رہے ہیں، جن میں Blackwel…
3 shared topics, same research avenue.
یونیورسل انٹیلیجنس معیشت: AI، روبوٹکس، ملازمتیں، پیسہ، اور 2030–2035 کی منتقلی
AI کمپنیاں ایک ذہنی اور جسمانی محنت کے نظام کو ترتیب دے رہی ہیں جو انسانی کام کو بڑھانے کے لیے ڈیزائن کیا گیا ہے۔ یہ پیش گوئی 6–18 ماہ کی ر…
3 shared topics, same research avenue.
حقیقت کا جال: شعور، ناظر، اور خلا-وقت کے نیچے کا میدان پرت
ڈونلڈ ہوفمین حقیقت کے قریب ہیں کیونکہ وہ انٹرفیس سے باہر نکلنے کی کوشش کر رہے ہیں۔ ٹام بلیو ابھی بھی انٹرفیس کی وضاحت کرنے کی کوشش کر رہے ہ…
3 shared topics.
تبصرے (0)
Security Check
Please complete the captcha to verify you are human.